服务器池
服务器池组织一个或多个后端节点,并结合健康检查、负载均衡算法及可选的虚拟组配置分配请求。节点由监听地址和端口标识;同一主机的不同端口可以作为不同节点。
点击【负载流量管理-服务器池】菜单,默认按照服务器池创建时间倒序排列展示所有服务器池信息列表。吞吐量数字部分表示当前数据,当鼠标移入折线图时数字变为鼠标所在的纵坐标值。 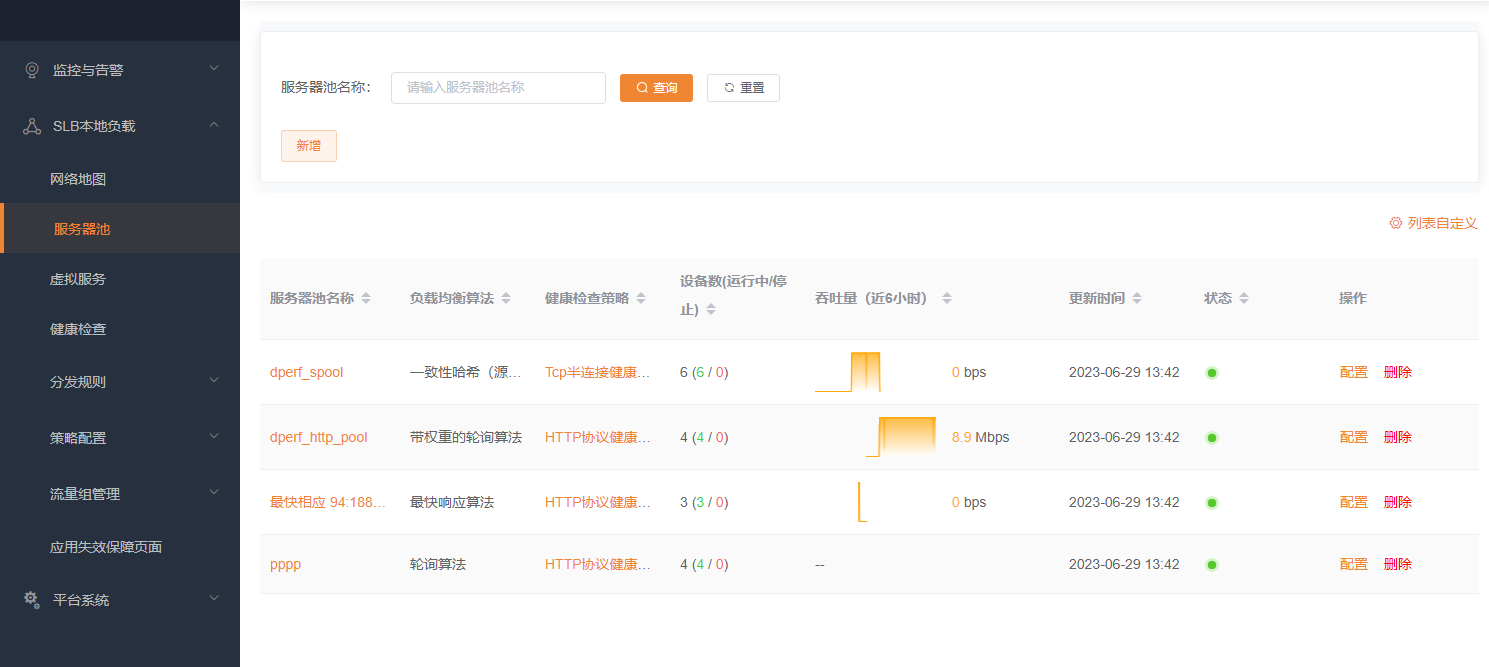
- 查询区域:
可通过 “服务器池名称”属性,进行条件查询操作。点击“查询”按钮执行查询操作,点击“重置”按钮将查询条件清空;
- 数据区域:
新增服务器池:点击列表上方“新增”按钮,弹框打开服务器池新增页面,可添加/配置新的服务器池信息。 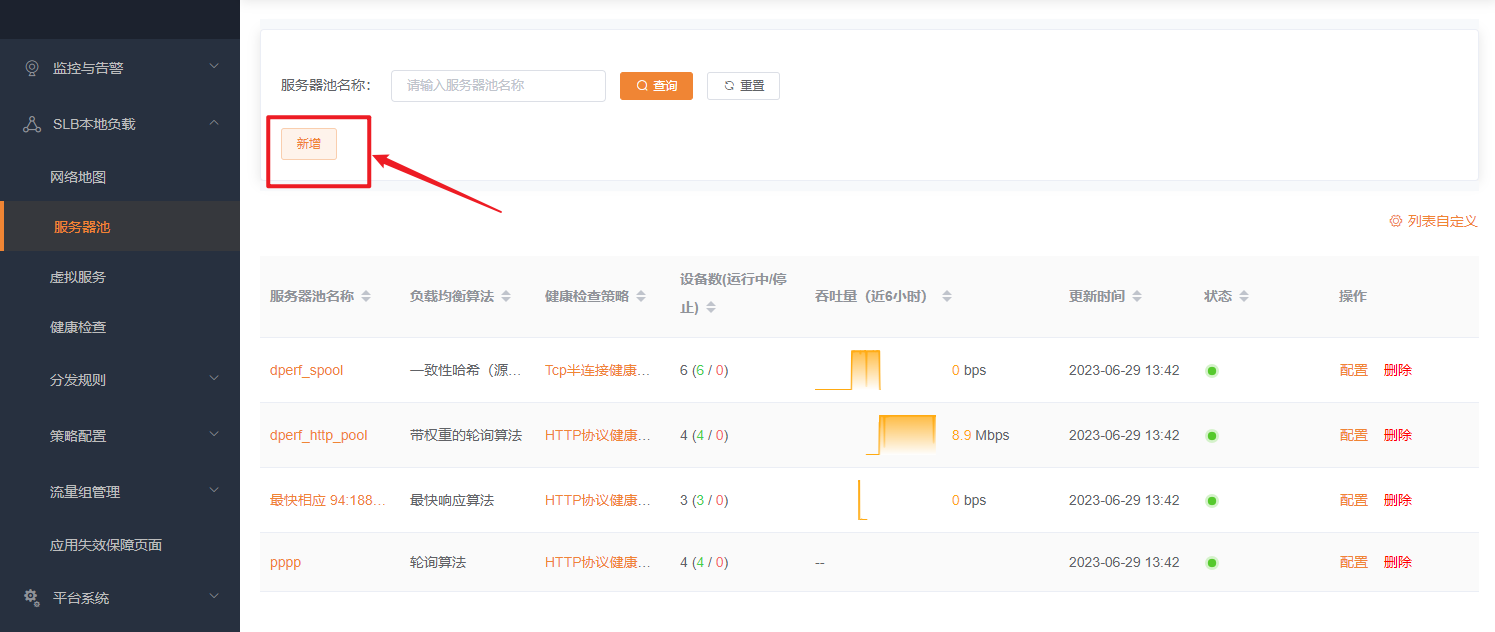
提示
注:服务器池可以跨转发引擎集群使用。
每个服务器节点可以设置开启状态。
创建后还需由实际命中的分发规则引用该池。健康检查策略和发起探测的引擎也需关联到服务器池,参见健康检查配置指南。
域名节点
目标节点的监听地址可填写完整域名,端口填写应用端口。创建前先在【负载流量管理 → 域名解析 → DNS服务器】配置能够解析该域名的服务器;域名解析、健康检查及应用网络都需可用。
保存并执行必要变更后,在“DNS缓存”中按完整域名核对地址,再用实际业务响应和后端标识确认请求已到达节点。操作示例见内部域名作为 SLB 后端节点。
温暖上线
先开启服务器池的“温暖上线”,再填写下列时间。时间单位为秒,与健康检查页面的毫秒不同。
| 字段 | 含义 |
|---|---|
| 恢复时间 | 节点重新可用后的等待阶段,在该阶段暂不向它分配流量;范围 0–600 秒,0 关闭该阶段 |
| 温暖时间 | 等待结束后逐步增加节点流量的阶段;范围 0–600 秒,0 关闭该阶段 |
健康检查负责判断节点是否可用,温暖上线控制可用后如何恢复接收流量。页面显示健康不意味着已经达到稳定流量比例,也不意味着两项时间能够替代健康检查。
故障恢复验证应保留其他健康节点继续承载流量。全池节点均异常后的恢复路径可能直接恢复分配,不能把“恢复时间”当作任何情况下都强制阻断请求的定时器;整池恢复与单节点恢复应分别观察。
保存并处理必要的配置变更后,使用持续请求分别观察节点异常、恢复等待、流量爬升和稳定阶段。不要仅在保存后请求一次就判定有效。操作及观察方法见节点上线与维护下线。
注意
免费版用户不支持温暖上线功能。
负载均衡算法
可选轮询算法、带权重的轮询算法、一致性哈希算法、最小连接数算法、最快响应算法。
当选择带权重的轮询算法或最小连接数算法时,下方节点池会开启权重配置(0-100);当选择一致性哈希算法时,可配置哈希类型和哈希键,将基于哈希键进行负载均衡算法,可选哈希类型:URI、COOKIE、URL 参数、HEADER、源地址。 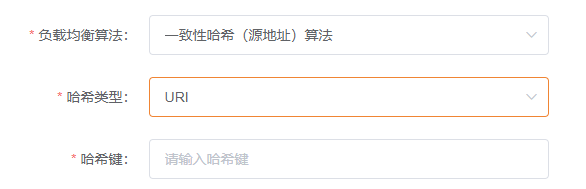
虚拟组
在服务器池的“节点信息”中开启“是否开启虚拟组”,填写“组中最少健康节点数量”,再新增虚拟组及节点。服务器池的虚拟组用于后端分组,与承载 VIP 的主备流量组是不同对象。
权重、优先级与健康阈值
| 字段 | 作用 | 容易误配的地方 |
|---|---|---|
| 优先级 | 1–65535,数字越大优先级越高 | 较低等级不是按权重同时分流,而是在较高等级不满足健康条件时参与回退 |
| 虚拟组权重 | 0–1000,同一可用优先级内控制组间分流;0 表示不分配流量 | 不等于优先级,也不等于组内节点权重 |
| 组中最少健康节点数量 | 对同一优先级中参与候选的组汇总健康节点数,决定该等级能否承载流量 | 不是要求每一个组都单独达到这个数;权重为 0 的组不计入候选健康数量 |
| 节点权重 | 在选中的组内,结合算法分配到具体节点 | 还受节点健康、会话保持和连接复用影响 |
权重与优先级在虚拟组弹框中配置;健康节点阈值在外层服务器池页面配置。选择过程为:先找达到健康阈值的最高优先级,再在该等级的可用组之间分流,最后选择具体节点。
例如高优先级有两个健康节点,阈值为 2:其中一个节点异常后,该等级不再满足条件,将使用下一满足条件的等级;恢复为两个健康节点后重新优先选择高等级。阈值改为 1 时,一个健康节点即可让高等级继续承载流量,但它也可能承受更多负载。
组内部分节点异常会影响可分配权重,实际比例还受算法、连接时长和保持策略影响。不要将几次请求的比例当成固定百分比承诺。变更优先级、权重或阈值后,应同时核对健康状态与实际后端分布,见发布策略指南。
注意
免费版用户不支持虚拟组功能。
AI模式
在服务器池基础信息配置中打开“启用AI模式”,节点配置区域将切换为模型推理组配置。 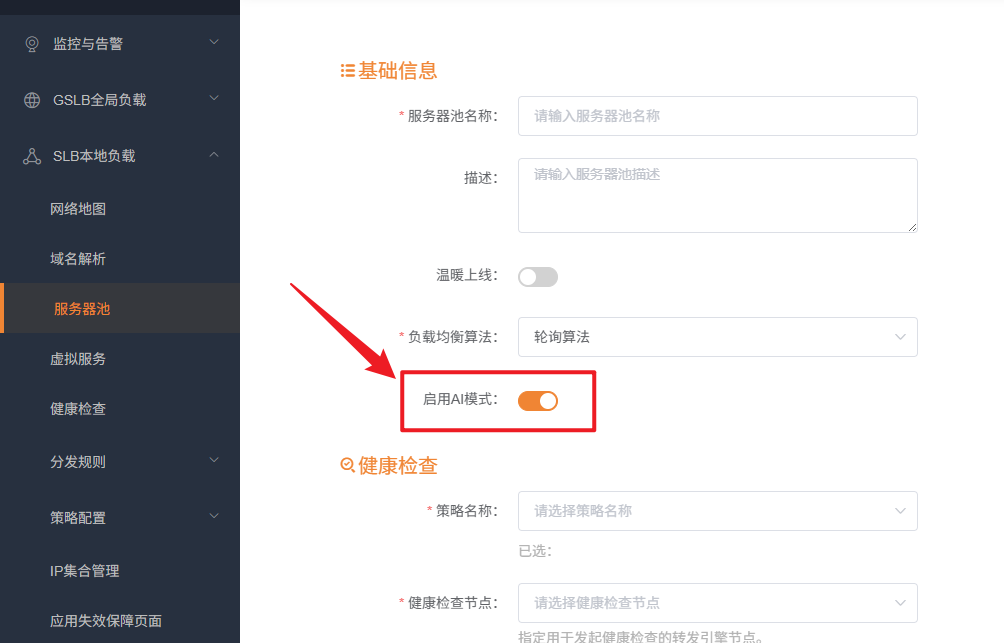
AI 模式下可设置“推理组最少就绪实例数”。使用普通 AI 调度与推理组 Fallback 时,该值用于判断一个优先级等级是否具备承载流量的健康节点数量。选择语义算法时,应按下方“语义路由设置”理解选路,不能直接套用普通 Fallback 的优先级与权重分配步骤。
点击模型推理组的“新增”按钮,配置推理组及其 AI 服务器节点: 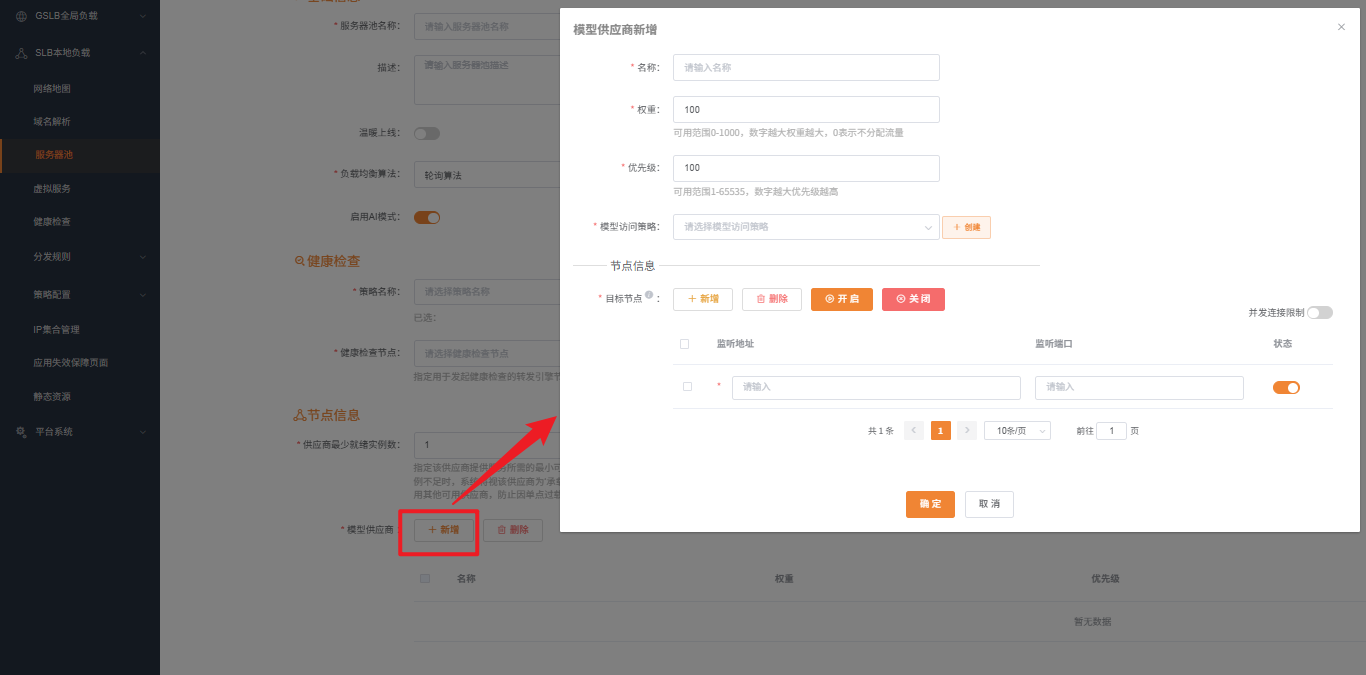
模型推理组主要字段如下:
- 推理组名称:当前推理组的唯一标识。
- 优先级:取值范围为 1-65535;普通 AI Fallback 调度中,数字越大,优先级越高。
- 推理组权重:取值范围为 0-1000;普通 AI 调度中,用于同一优先级内多个推理组之间的流量分配。
- 模型访问策略:定义该组访问后端模型时使用的协议、鉴权、模型名称和推理参数。组内节点共用此策略。
- 服务器节点:每个推理组至少配置一个节点;节点可分别设置监听地址、端口和节点权重。
语义路由设置
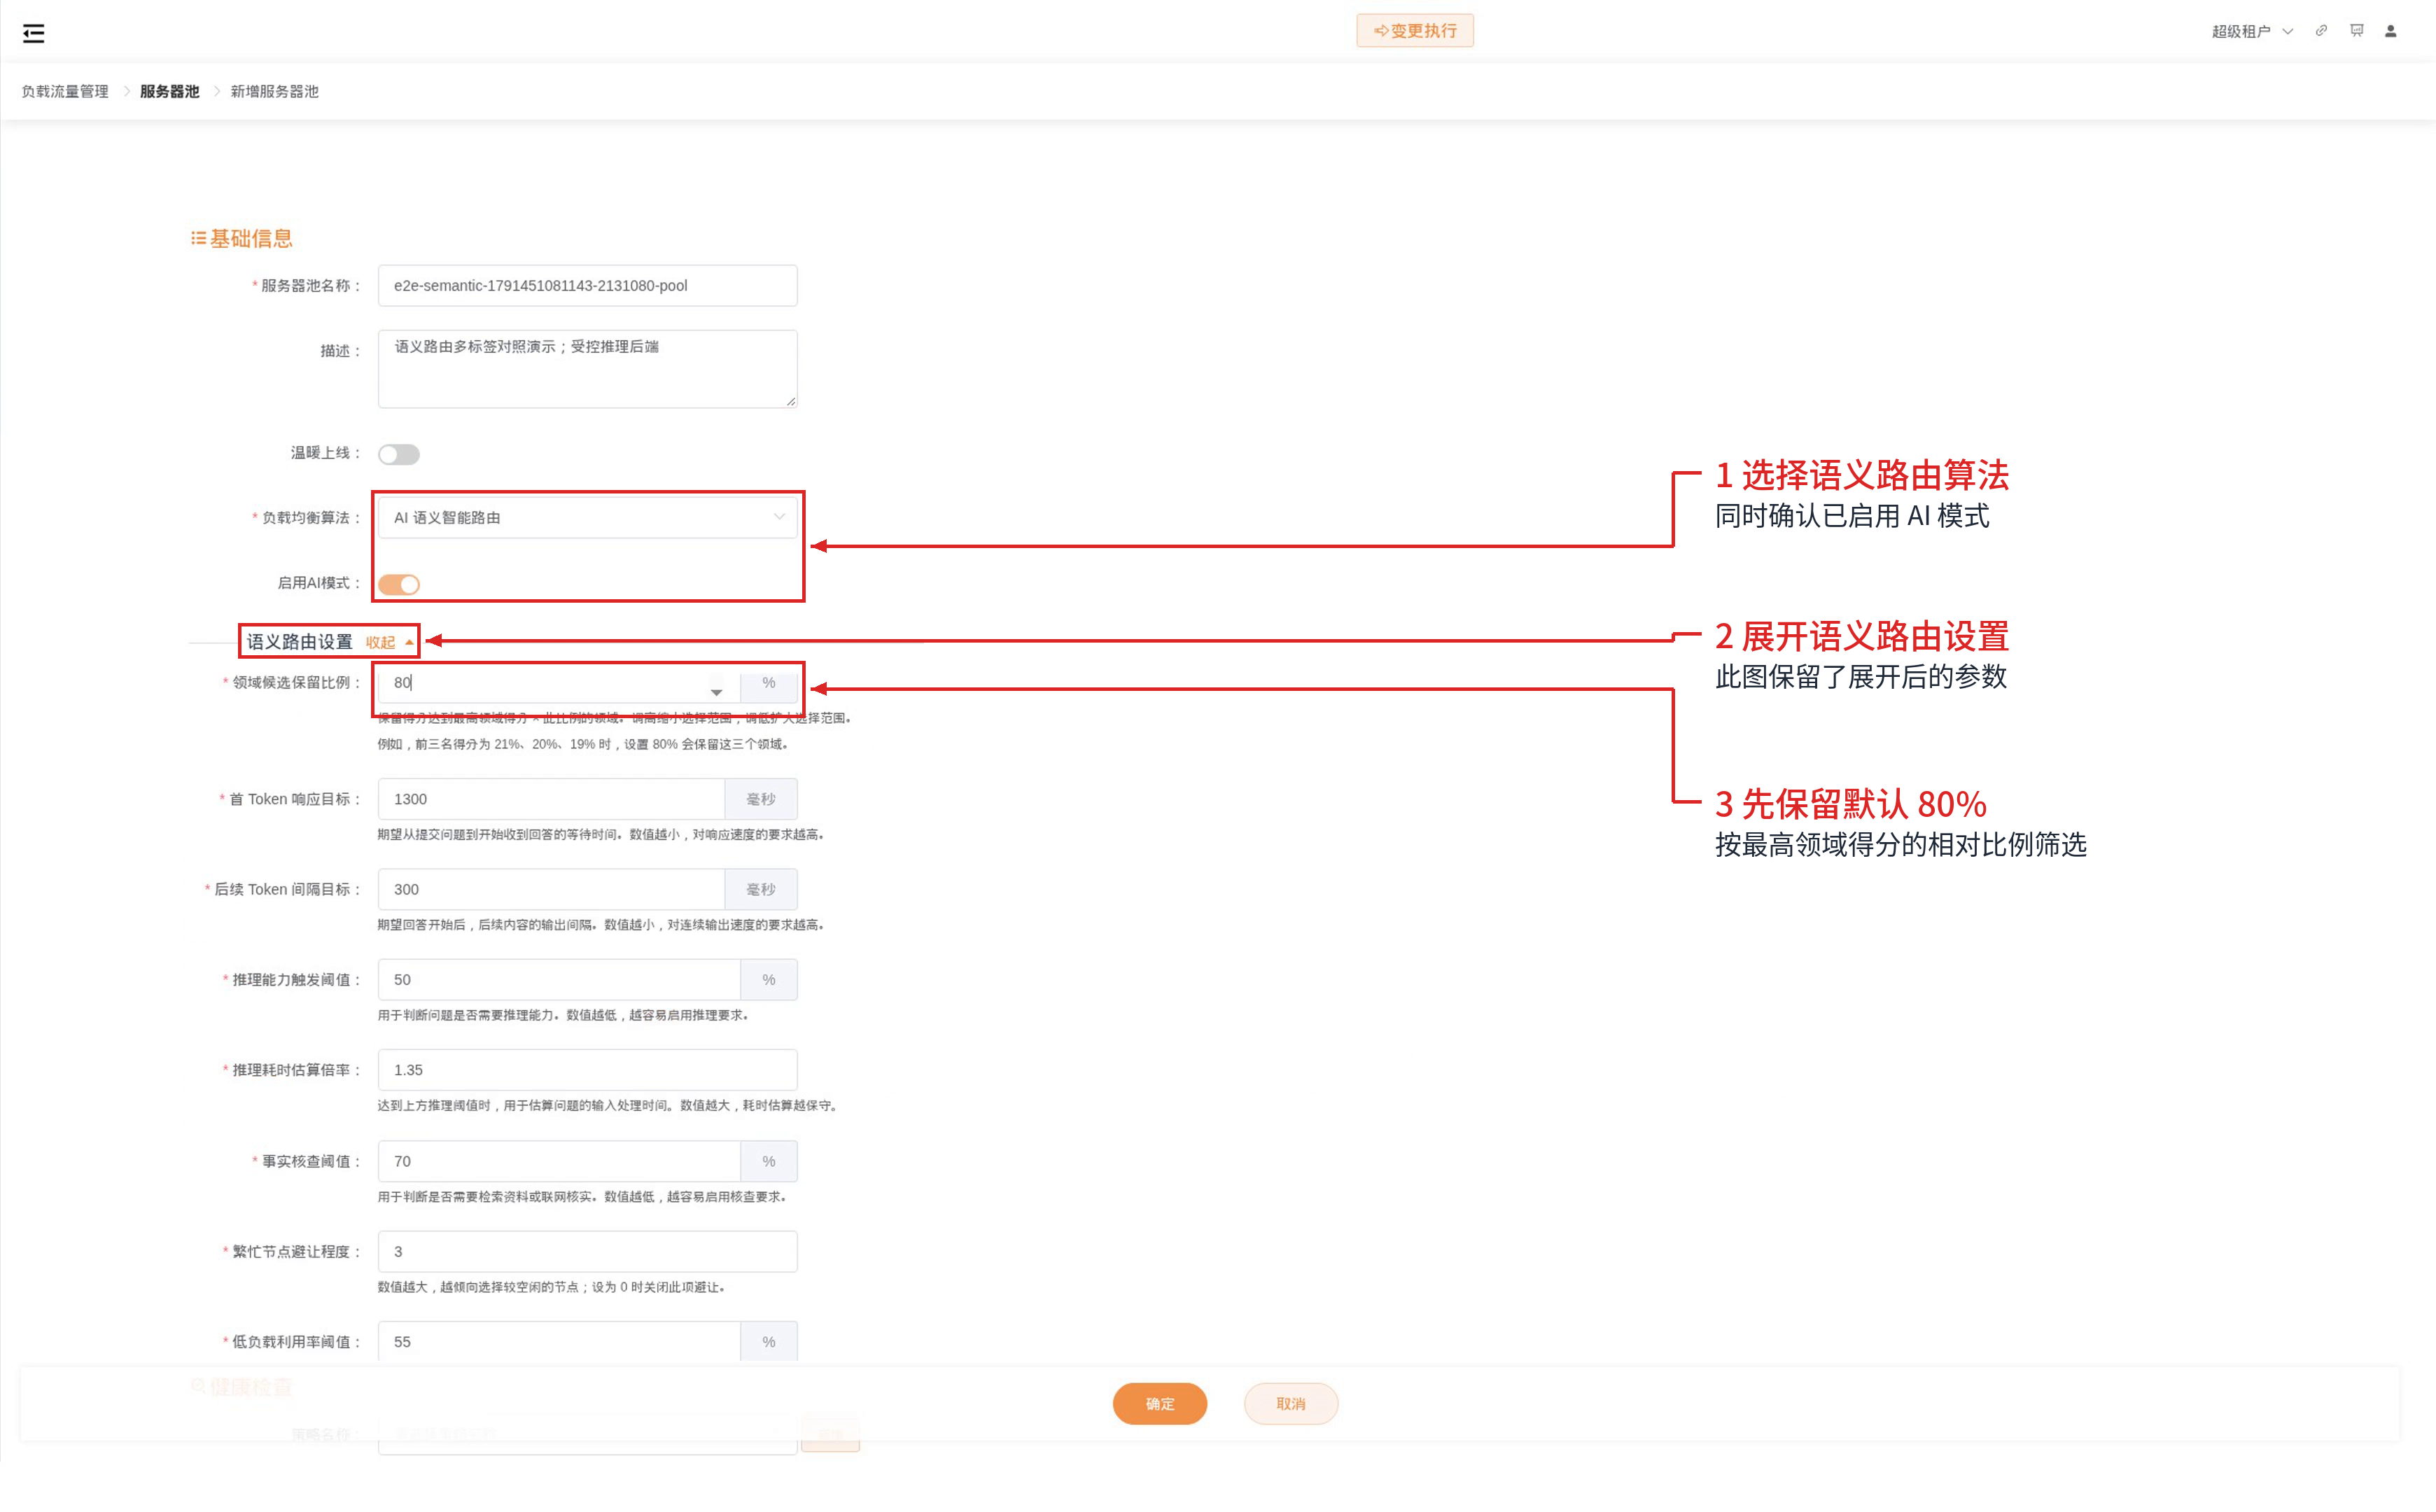
启用 AI 模式并将“负载均衡算法”选择为“AI 语义智能路由”后,可配置语义路由设置。系统结合请求所属领域、任务需求、模型能力和节点负载选择推理组。
使用前,需要完成三个关联:
- 在模型访问策略中填写真实后端模型名称、擅长领域、支持意图等信息。
- 每个模型推理组选择对应的模型访问策略,并添加可以实际接收模型请求的节点。领域和能力配置在模型访问策略中,不是填写到推理组名称中。
- 引用该池的AI虚拟服务开启语义分析,并配置可用的语义引擎。只有服务器池选择算法、虚拟服务未启用语义分析,不能形成完整的语义选路配置。
保存并执行配置变更后,以客户端 model: "auto" 发起请求,核对实际命中的推理组和后端模型。完整示例见配置AI语义路由。
语义路由设置默认折叠,点击“展开”可查看和调整全部参数。通常可保留默认值;需要调整时,建议每次只修改一项,结合实际请求观察变化。
| 参数 | 默认值 | 含义与调整方法 |
|---|---|---|
| 领域候选保留比例 | 80% | 保留与最高得分领域足够接近的领域。调高会缩小候选范围,调低会扩大候选范围。 |
| 首 Token 响应目标 | 1300 毫秒 | 希望模型开始输出回答的等待时间。数值越小,对开始响应的速度要求越高。 |
| 后续 Token 间隔目标 | 300 毫秒 | 希望模型持续输出回答时,相邻输出单元的平均间隔。数值越小,对持续输出的速度要求越高。 |
| 推理能力触发阈值 | 50% | 请求的推理需求达到此值时,优先考虑具有相应推理能力的模型。调低后,更多请求会考虑这项偏好。 |
| 推理耗时估算倍率 | 1.35 | 对达到推理能力触发阈值的请求,适当增加预计的输入处理耗时。数值越大,选路时对这部分耗时的估计越保守。 |
| 事实核查阈值 | 70% | 请求的事实核查需求达到此值时,优先考虑具备知识库检索或联网查询能力的模型。调低后,更多请求会考虑这项偏好。 |
| 繁忙节点避让程度 | 3 | 控制节点繁忙程度对选路的影响。调高后,更倾向于避开繁忙节点;调低后,这方面的影响减弱。 |
| 低负载利用率阈值 | 55% | 用于判断当前是否处于低负载状态。条件满足时,优先考虑回答质量;负载升高后,逐步兼顾响应速度与使用成本。调高会扩大低负载状态的范围。 |
Token 是模型处理文字的基本单位,不一定等于一个汉字或单词。两项响应目标共同用于选择预计响应更合适的节点,不是请求超时时间,也不保证每次请求都达到目标。调整前可参考实际请求的响应表现。
事实核查阈值触发的是知识能力偏好。当前选路把模型访问策略中的“检索增强”和“联网”同样视为匹配,不能靠此阈值决定请求只能查内部制度库或只能查公开网络资料。两类能力都必须由真实后端提供,标签本身不会接通知识库或开放网络;具体配置见外部知识能力如何填写。
领域候选保留比例的计算方式是:候选领域的得分不低于最高得分 × 保留比例。80% 表示与最高得分相比的保留范围,不表示识别准确率必须达到 80%。以下为计算示例,分数是假设值,不代表实际问题的识别结果:
| 领域得分 | 保留比例 | 保留的领域 |
|---|---|---|
| 法律 47%、经济学 24%、商业 20%,其余更低 | 80% | 法律 |
| 法律 45%、经济学 43%、商业 12% | 80% | 法律、经济学 |
| 法律 21%、经济学 20%、商业 19%,其余均低于 16.8% | 80% | 法律、经济学、商业 |
候选领域不限于两个或三个;得分达到边界的领域也会保留。推理组只需匹配其中一个候选领域,即可获得领域匹配,无需同时具备所有候选领域。没有领域匹配也不等于立即排除,其他能力匹配仍会参与比较。
“请求的候选领域”与“模型擅长领域”是两组信息:前者由语义引擎分析本次请求并按比例保留,后者由管理员在模型访问策略中配置。两组存在交集即可命中领域;给模型增加标签不会提高语义引擎对请求领域的识别得分,也不保证模型胜出。
推理能力触发阈值决定哪些请求需要推理能力,推理耗时估算倍率决定如何估计这些请求的输入处理耗时。例如,阈值为 50%、倍率为 1.35 时,推理需求达到 50% 的请求,原本预计为 100 毫秒的输入处理时间按 135 毫秒参与选路。倍率不会改变模型的实际处理速度,也不会调整请求超时时间。
质量与成本的比较依赖模型访问策略中的相应配置。调整低负载利用率阈值前,应先核对模型的质量等级和成本信息;存在等待请求等情况时,系统也会结合实际负载判断,不只依据这个百分比。
候选领域没有可用推理组时
部分候选领域没有合适的推理组时,其余领域的匹配仍然有效。模型只满足部分任务偏好时,也可参与选择;系统综合已匹配的能力、预计响应速度及适用的质量和成本配置进行比较。
没有领域匹配时,系统仍会考虑推理、任务类型等其他匹配。无法取得有效语义输入或无法完成语义选路时,可通过日志中的“语义路由选择来源”和“语义路由回退原因”核对实际处理路径。节点仍需满足健康状态、访问授权、容量及当前选路要求;没有符合条件的节点时,无法转发请求。
领域匹配并不是唯一的选择条件。其他任务偏好、响应表现、质量配置、访问授权和节点状态也会影响最终选择。缺少某一项任务偏好不会抹去已经匹配的领域优势;无权访问或不可用的节点不能因领域匹配而被选中。
初次验证时,先保持响应目标等参数的默认值,每次只改变一个维度,例如增加一个领域标签、改变支持意图或关闭一个节点。使用同一问题进行前后对照,并新建会话避免历史消息改变输入。单次聊天的选路结果只说明当时配置和候选状态下的选择,不应据此总结所有情况下的固定优先级。
推理组Fallback
本节说明普通 AI 调度的优先级与权重回退。选择“AI 语义智能路由”时,请以上一节的领域、能力及可用性比较为准,不能用本节步骤预测语义选路结果。
网关按优先级从高到低判断推理组是否可用。同一优先级下所有推理组的健康节点数会被汇总;第一个达到“推理组最少就绪实例数”的优先级等级参与转发,低优先级等级作为故障回退资源。
同一优先级等级内存在多个可用推理组时,系统先按推理组权重分配流量,再按组内节点权重和服务器池负载均衡算法选择具体节点。因此,推理组权重和节点权重分别控制两级流量比例。
当高优先级等级的健康节点数低于阈值时,流量切换到下一满足阈值的等级;高优先级恢复并重新满足阈值后,再次优先承载流量。
修改服务器池
在服务器池列表中点击右侧“配置”按钮,可进入这个服务器池修改页面: 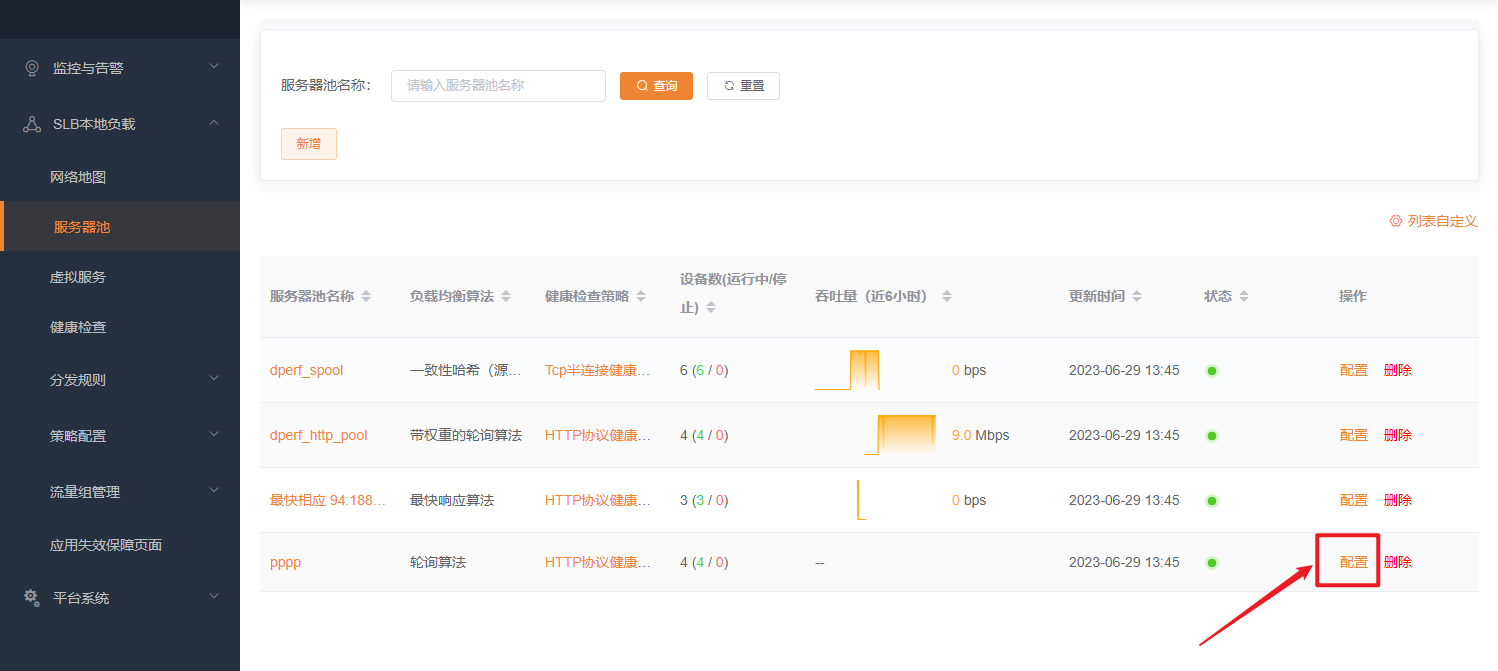
删除服务器池
删除前先核对引用此池的虚拟服务和分发规则,将业务切换到其他可用池。删除节点、关闭节点和调整权重是不同操作,不要用删除资源替代尚未验证的维护下线流程。
服务器池列表中,在要删除的服务器池条目右边点击“删除”按钮,可对这条服务器池进行删除操作。 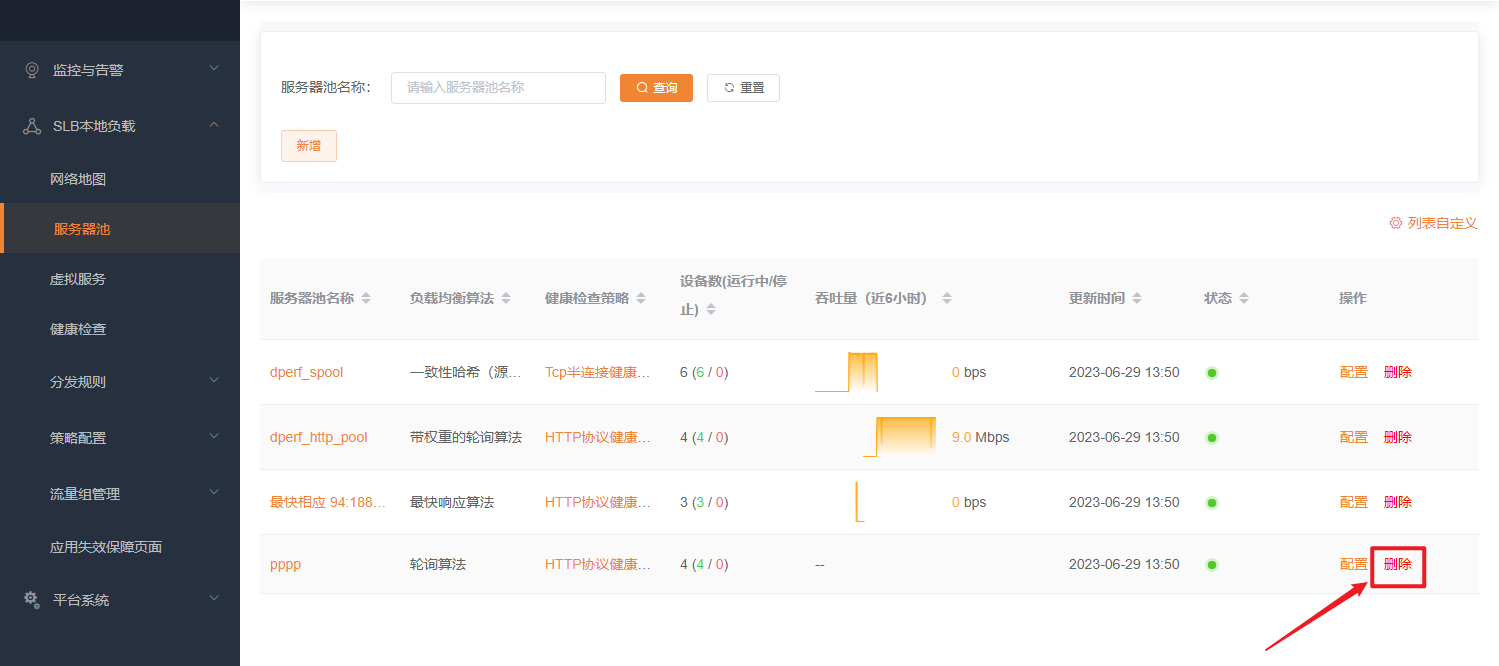
服务器池详情
点击服务器池列表的服务器池名称可进入这个服务器池详情页面,每个服务器池详情页面分 5 个模块:配置信息、服务器节点、分析、事件、异常。 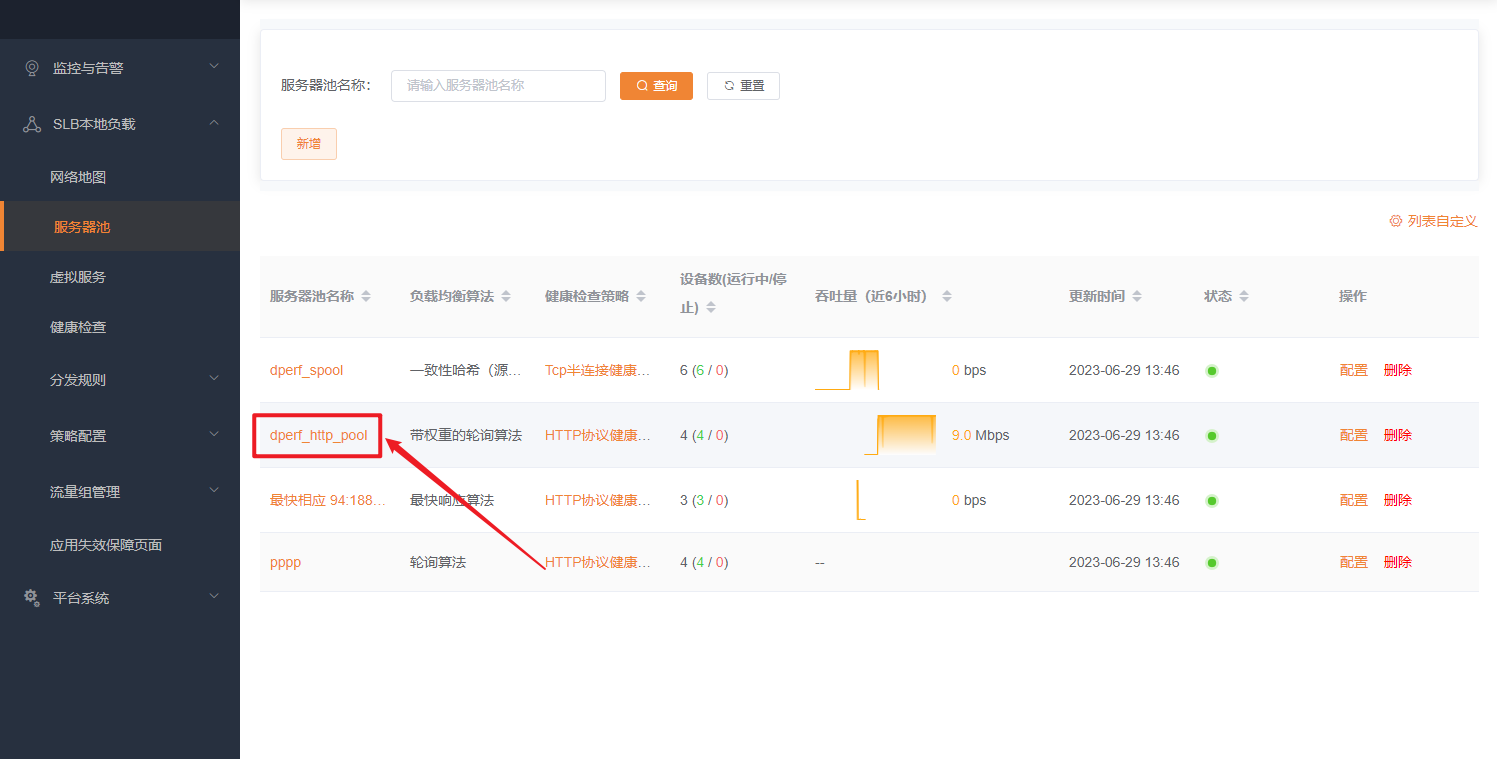
配置信息
在服务器池详情页面中,顶部的Tab页签点击第一个“配置信息”,可查看该服务器池的配置详情; 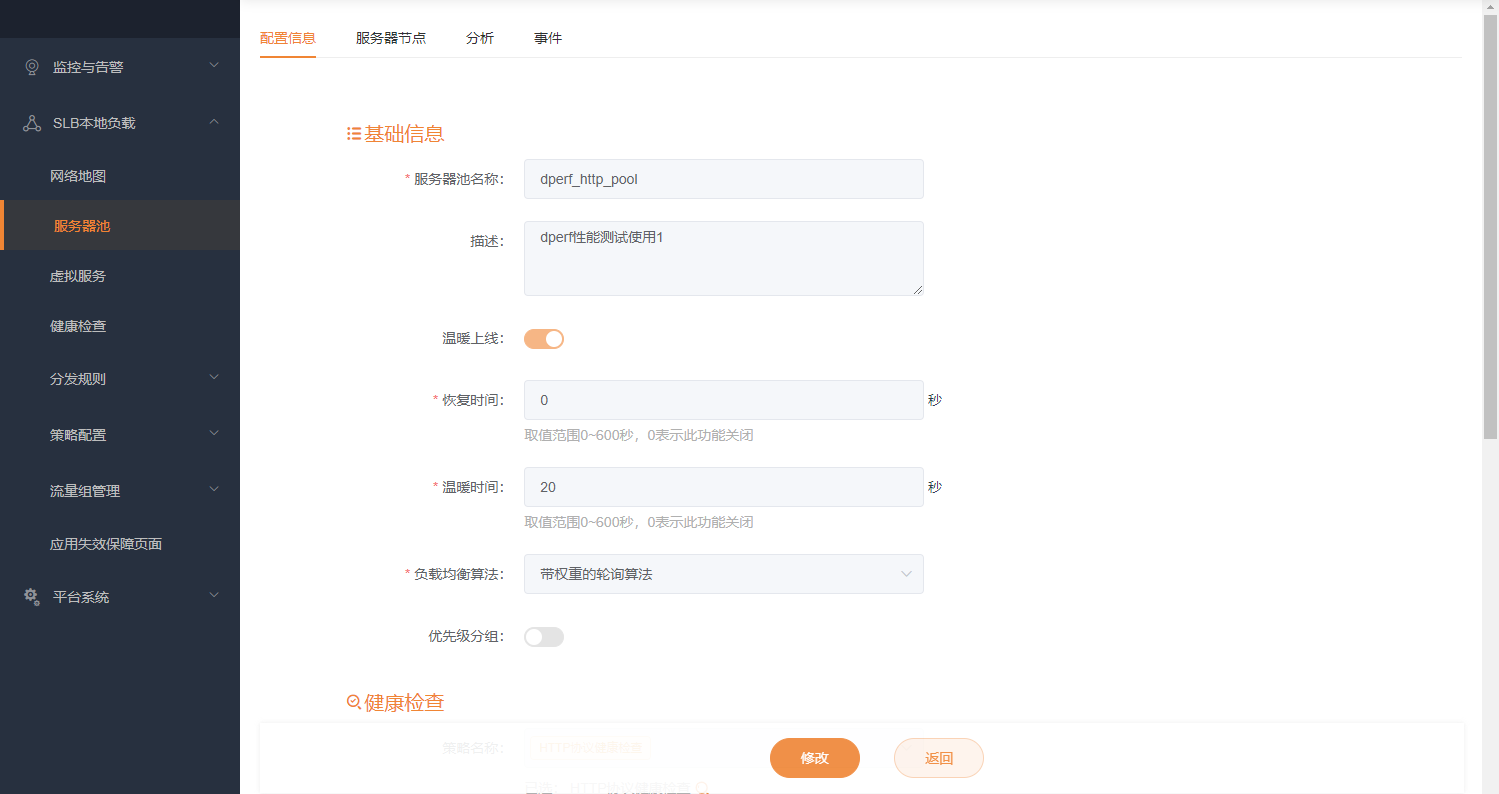
服务器节点
在服务器池详情页面中,顶部的Tab页签点击“服务器节点”,可查看该服务器池的节点详情,包括节点名称、监听地址、监听端口、节点状态、是否完成初次健康检查、近 6 小时吞吐量、近 6 小时请求数。表中折线图数字部分表示当前数据,当鼠标移入折线图时数字变为鼠标所在的纵坐标值。
查看服务器池节点详情:在节点列表中,点击节点名称或折线图可进入该节点分析页面。参见【负载流量管理-服务器池及节点-节点】章节。 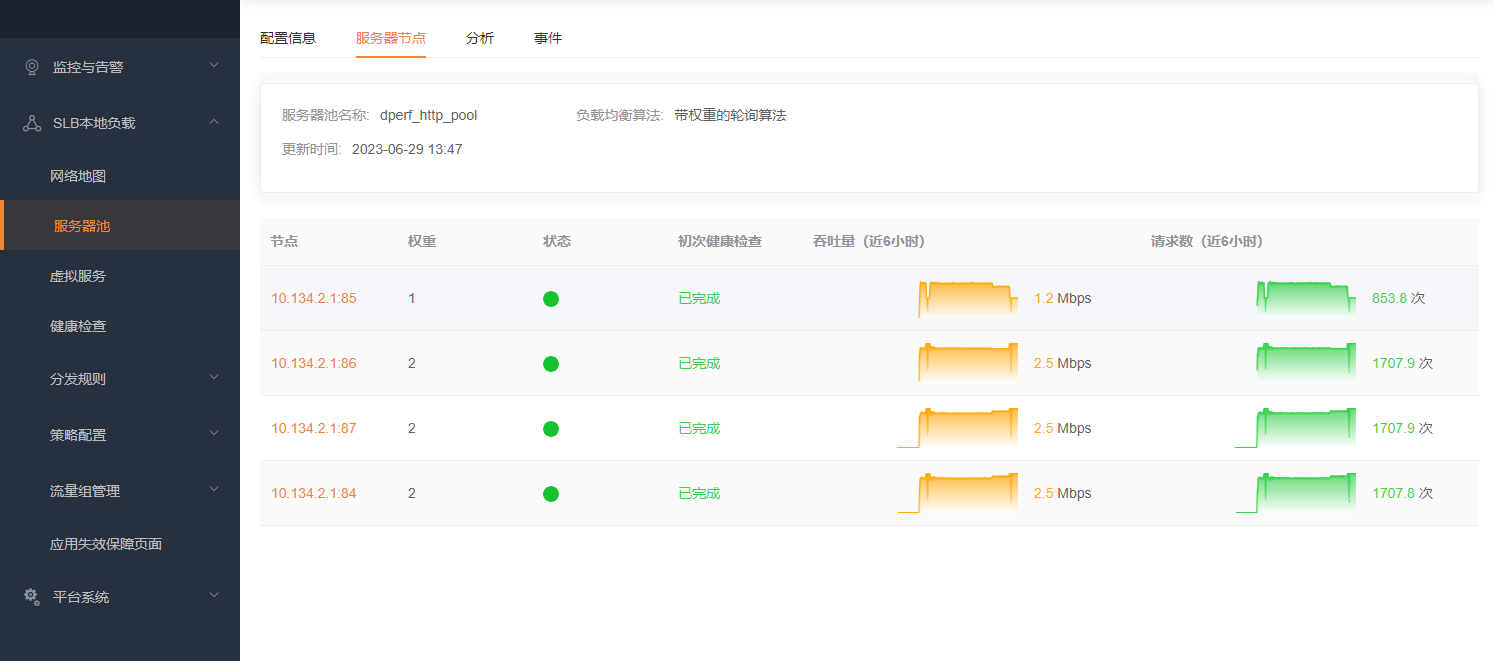
分析
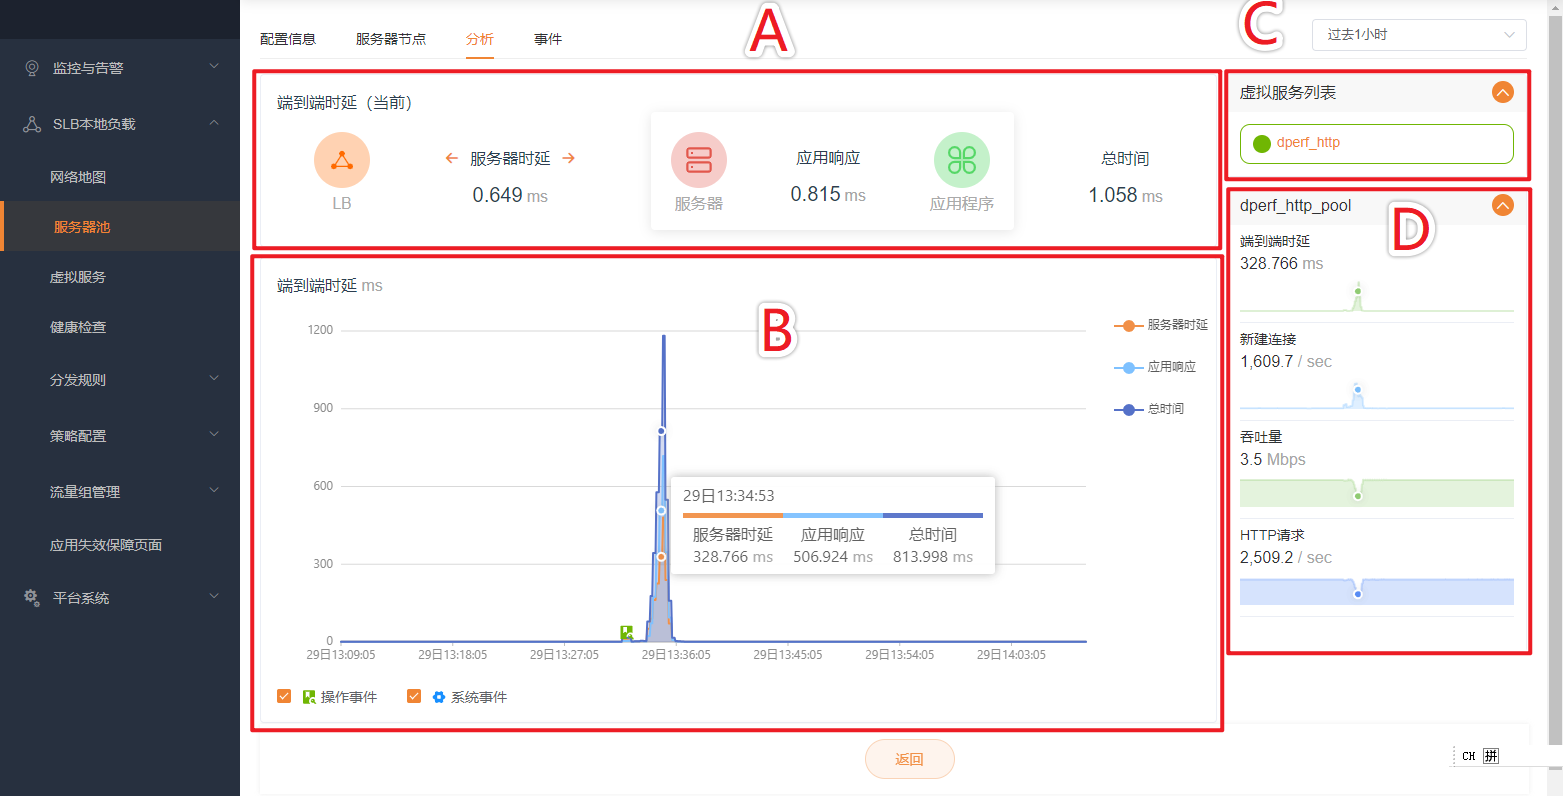
A 区各字段含义如下:
- 服务器时延:负载均衡与服务器之间的 TCP RTT 时延;
- 应用响应:从负载均衡开始转发请求,到服务器返回第一个报文的间隔时间;
- 总时间:处理一个请求的总耗费时间;
C 区展示引用该服务器池的虚拟服务列表;
D 区展示该服务器池对应时间段内“端到端时延”、“新建连接”、“吞吐量”、“HTTP 请求”。
交互功能参见【监控与告警-监控】章节的“分析”介绍。
事件
记录了所选时间段内该服务器池产生的系统事件和操作事件,横坐标为时间,纵坐标为事件数量,点击柱子会在下方列表展示这根柱子的时间段内的事件列表。 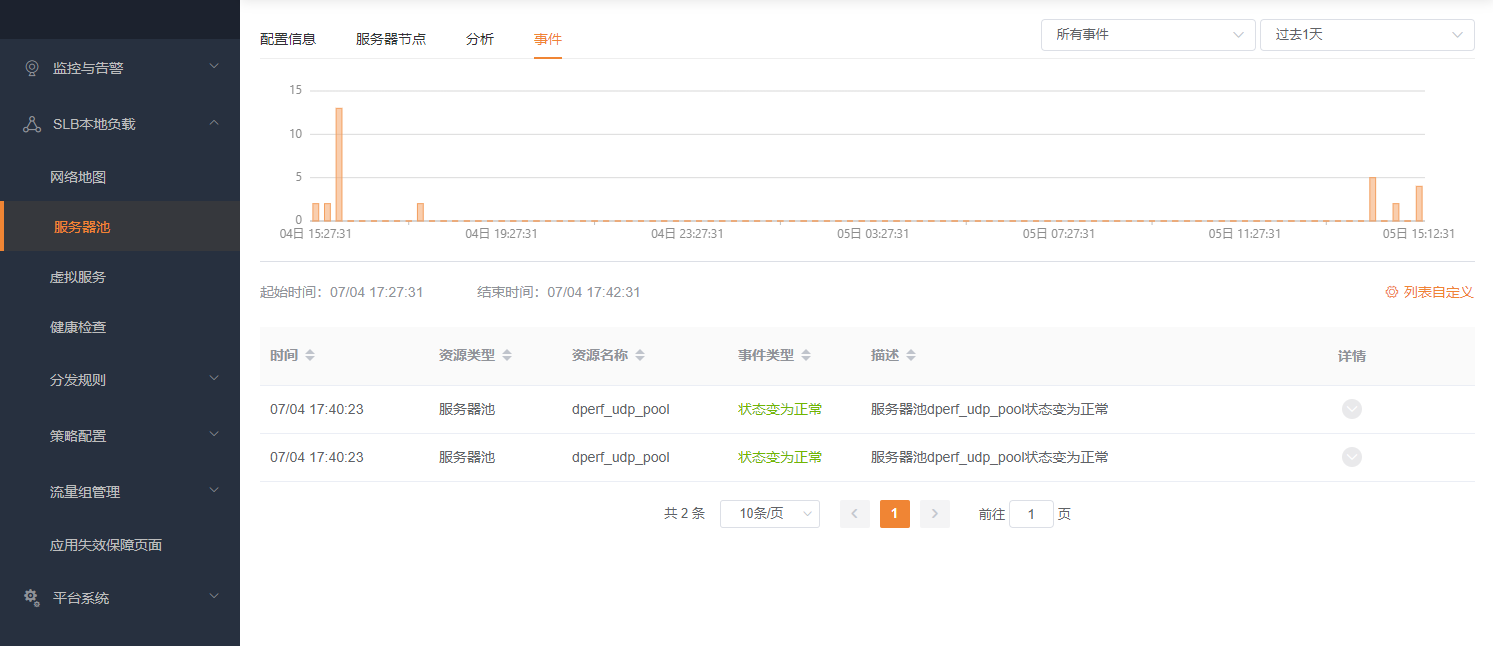 交互功能参见【监控与告警-监控】章节的“事件”介绍。
异常
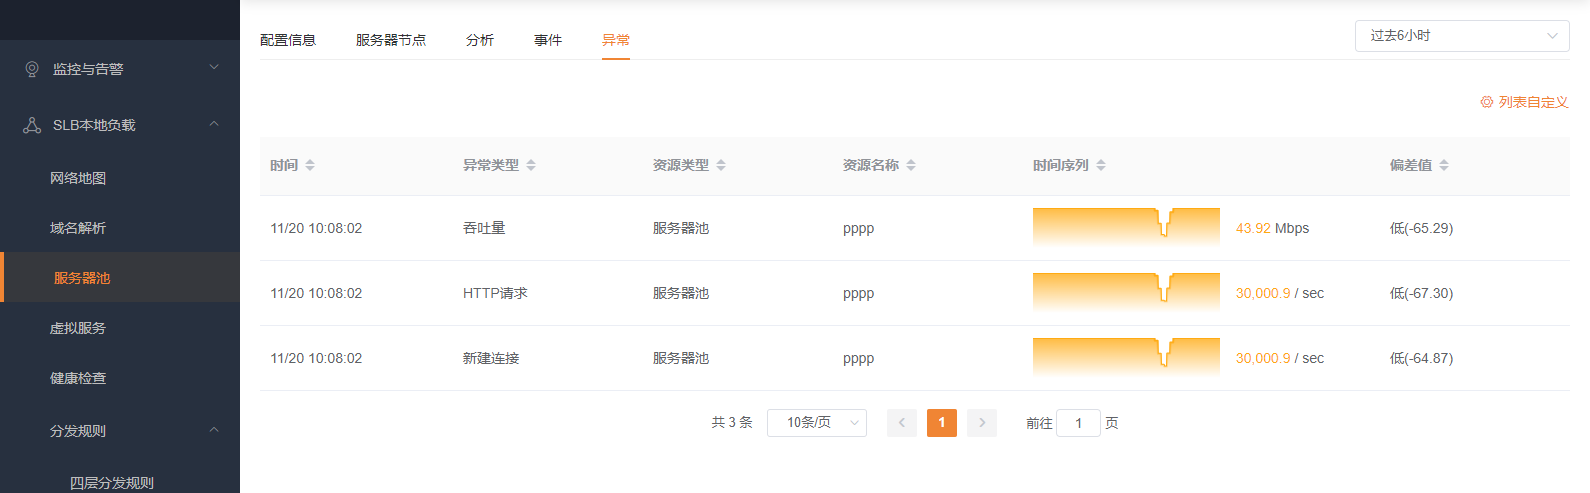
记录了所选时间段内该服务器池产生的异常。