配置AI语义路由
本指南说明如何让同一个 AI 访问入口,根据提问的领域和任务需求自动选择模型推理组。先完成页面配置并执行配置变更,再用 AIChat 聊天窗口验证。普通 AI 代理及按优先级回退的配置见快速创建大模型推理网关。
先分清四类配置
| 配置 | 在哪里设置 | 负责什么 |
|---|---|---|
| 语义引擎 | 平台系统 → 基础设施 → 语义引擎 | 分析提问的领域、任务类型和推理需求,不生成最终回答 |
| 模型访问策略 | 负载流量管理 → 策略配置 → AI大模型策略 | 配置后端模型名称、协议、鉴权和真实能力标签 |
| AI服务器池与模型推理组 | 负载流量管理 → 服务器池 | 关联访问策略和实际模型节点,选择语义路由算法 |
| AI虚拟服务 | 负载流量管理 → 虚拟服务 | 提供客户端入口,并关联服务器池和语义引擎 |
语义引擎可以与其他组件同机部署,也可以独立部署。无论部署在哪里,都要保证相关组件之间网络可达,并留出足够资源。不要把语义引擎地址填成后端模型节点地址。
一、准备可用的语义引擎与模型服务
在语义引擎列表查看已有引擎;没有时按语义引擎手册选择安装包和目标主机部署。等待安装完成,确认详情中的服务状态为“健康”。已有健康引擎可直接引用,不必为每个虚拟服务重复安装。
准备能够实际处理模型请求的后端节点,核对地址、端口、协议、模型名称及 API-Key。为真实业务配置合适的模型健康检查,确认节点可用后再验证选路。
本例面向政府与金融机构的运维人员,使用通用办公助手、法律合规助手、经济金融助手三个演示组。各组优先级、推理组权重和节点权重均为100;质量、成本等级为“未指定”,语言偏好为“无偏好”,外部知识能力为“无”,推理方式为“通用”。这些取值用于隔离能力标签的对照,不是生产模型的统一推荐值。
本例只讨论合同分析方法和经济学原理,不查询现行法规、单位内部制度或实时行情。后端返回可识别的演示标记,用于核对选路,不输出法律个案结论或投资建议。
二、为各组创建模型访问策略
分别创建三项策略,填写各自的后端协议、实际模型名称和鉴权信息,再展开“智能路由配置”。起始配置如下:
| 演示组 | 擅长领域 | 支持意图 | 模型名称 |
|---|---|---|---|
| 通用办公助手 | 通用 | 通用问答 | 通用办公后端实际接受的模型名 |
| 法律合规助手 | 法律 | 通用问答 | 法律合规后端实际接受的模型名 |
| 经济金融助手 | 经济学、商业 | 通用问答 | 经济金融后端实际接受的模型名 |
“经济金融助手”是本例的推理组名称;界面中的能力标签使用“经济学”和“商业”,没有单独的“金融”或“政务”选项。组名不参与领域分类。
“模型名称”填写后端真实名称,不要填 auto 来代替后端模型配置。auto 是稍后客户端请求网关自动选择模型时使用的值。
后续多标签对照时,法律合规助手同时选择法律和经济学;起始配置先只选法律。
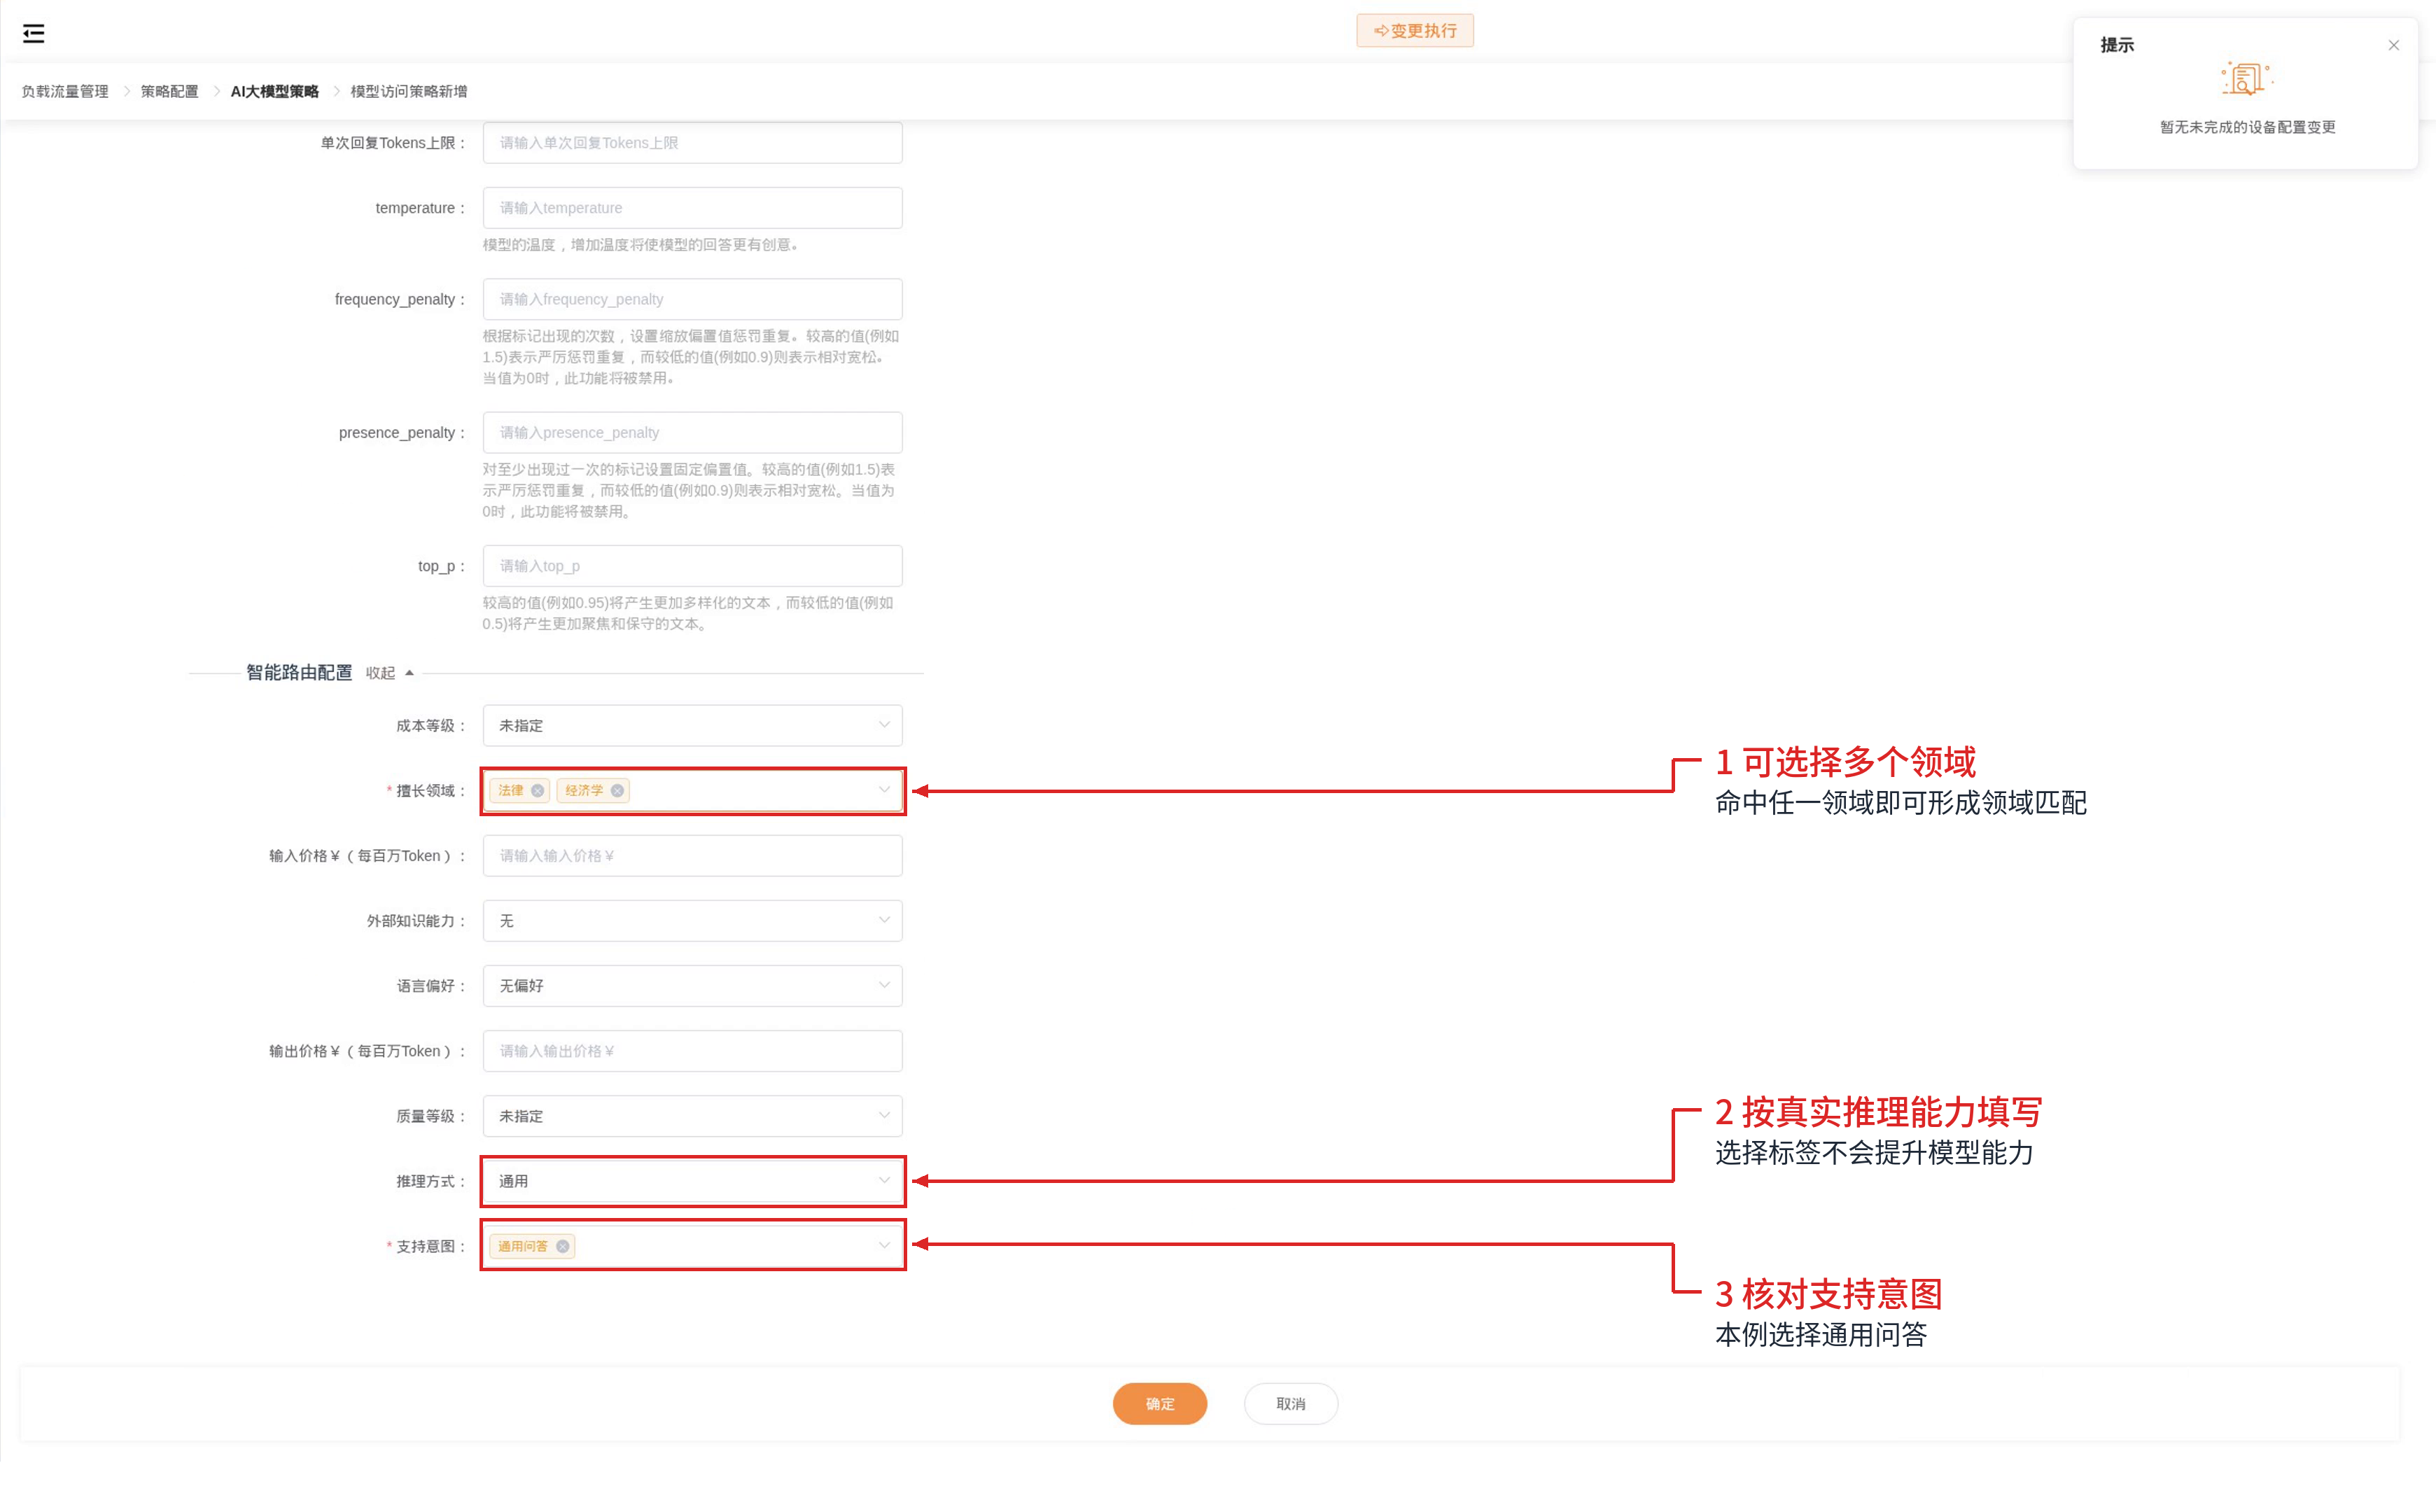
多个领域标签表示“可以匹配其中任一领域”,不是要求提问同时属于所有领域,也不是标签越多越优先。支持意图描述任务类型,例如合同内容也可能要求翻译或摘要。应按模型真实能力填写;勾选“联网”或“深度推理”不会替后端增加相应功能。
不同组需要不同能力时,应分别创建策略。修改一项被多个组共用的策略,会同时改变这些组的配置。更多字段见模型访问策略。
三、创建语义服务器池和推理组
新增服务器池,将负载均衡算法设为“AI 语义智能路由”,确认“启用AI模式”已经打开。展开“语义路由设置”,本例保留领域候选比例80%,其他参数先保留默认值。
服务器池的算法与候选比例、模型访问策略的能力标签分别配置,属于两个不同对象。
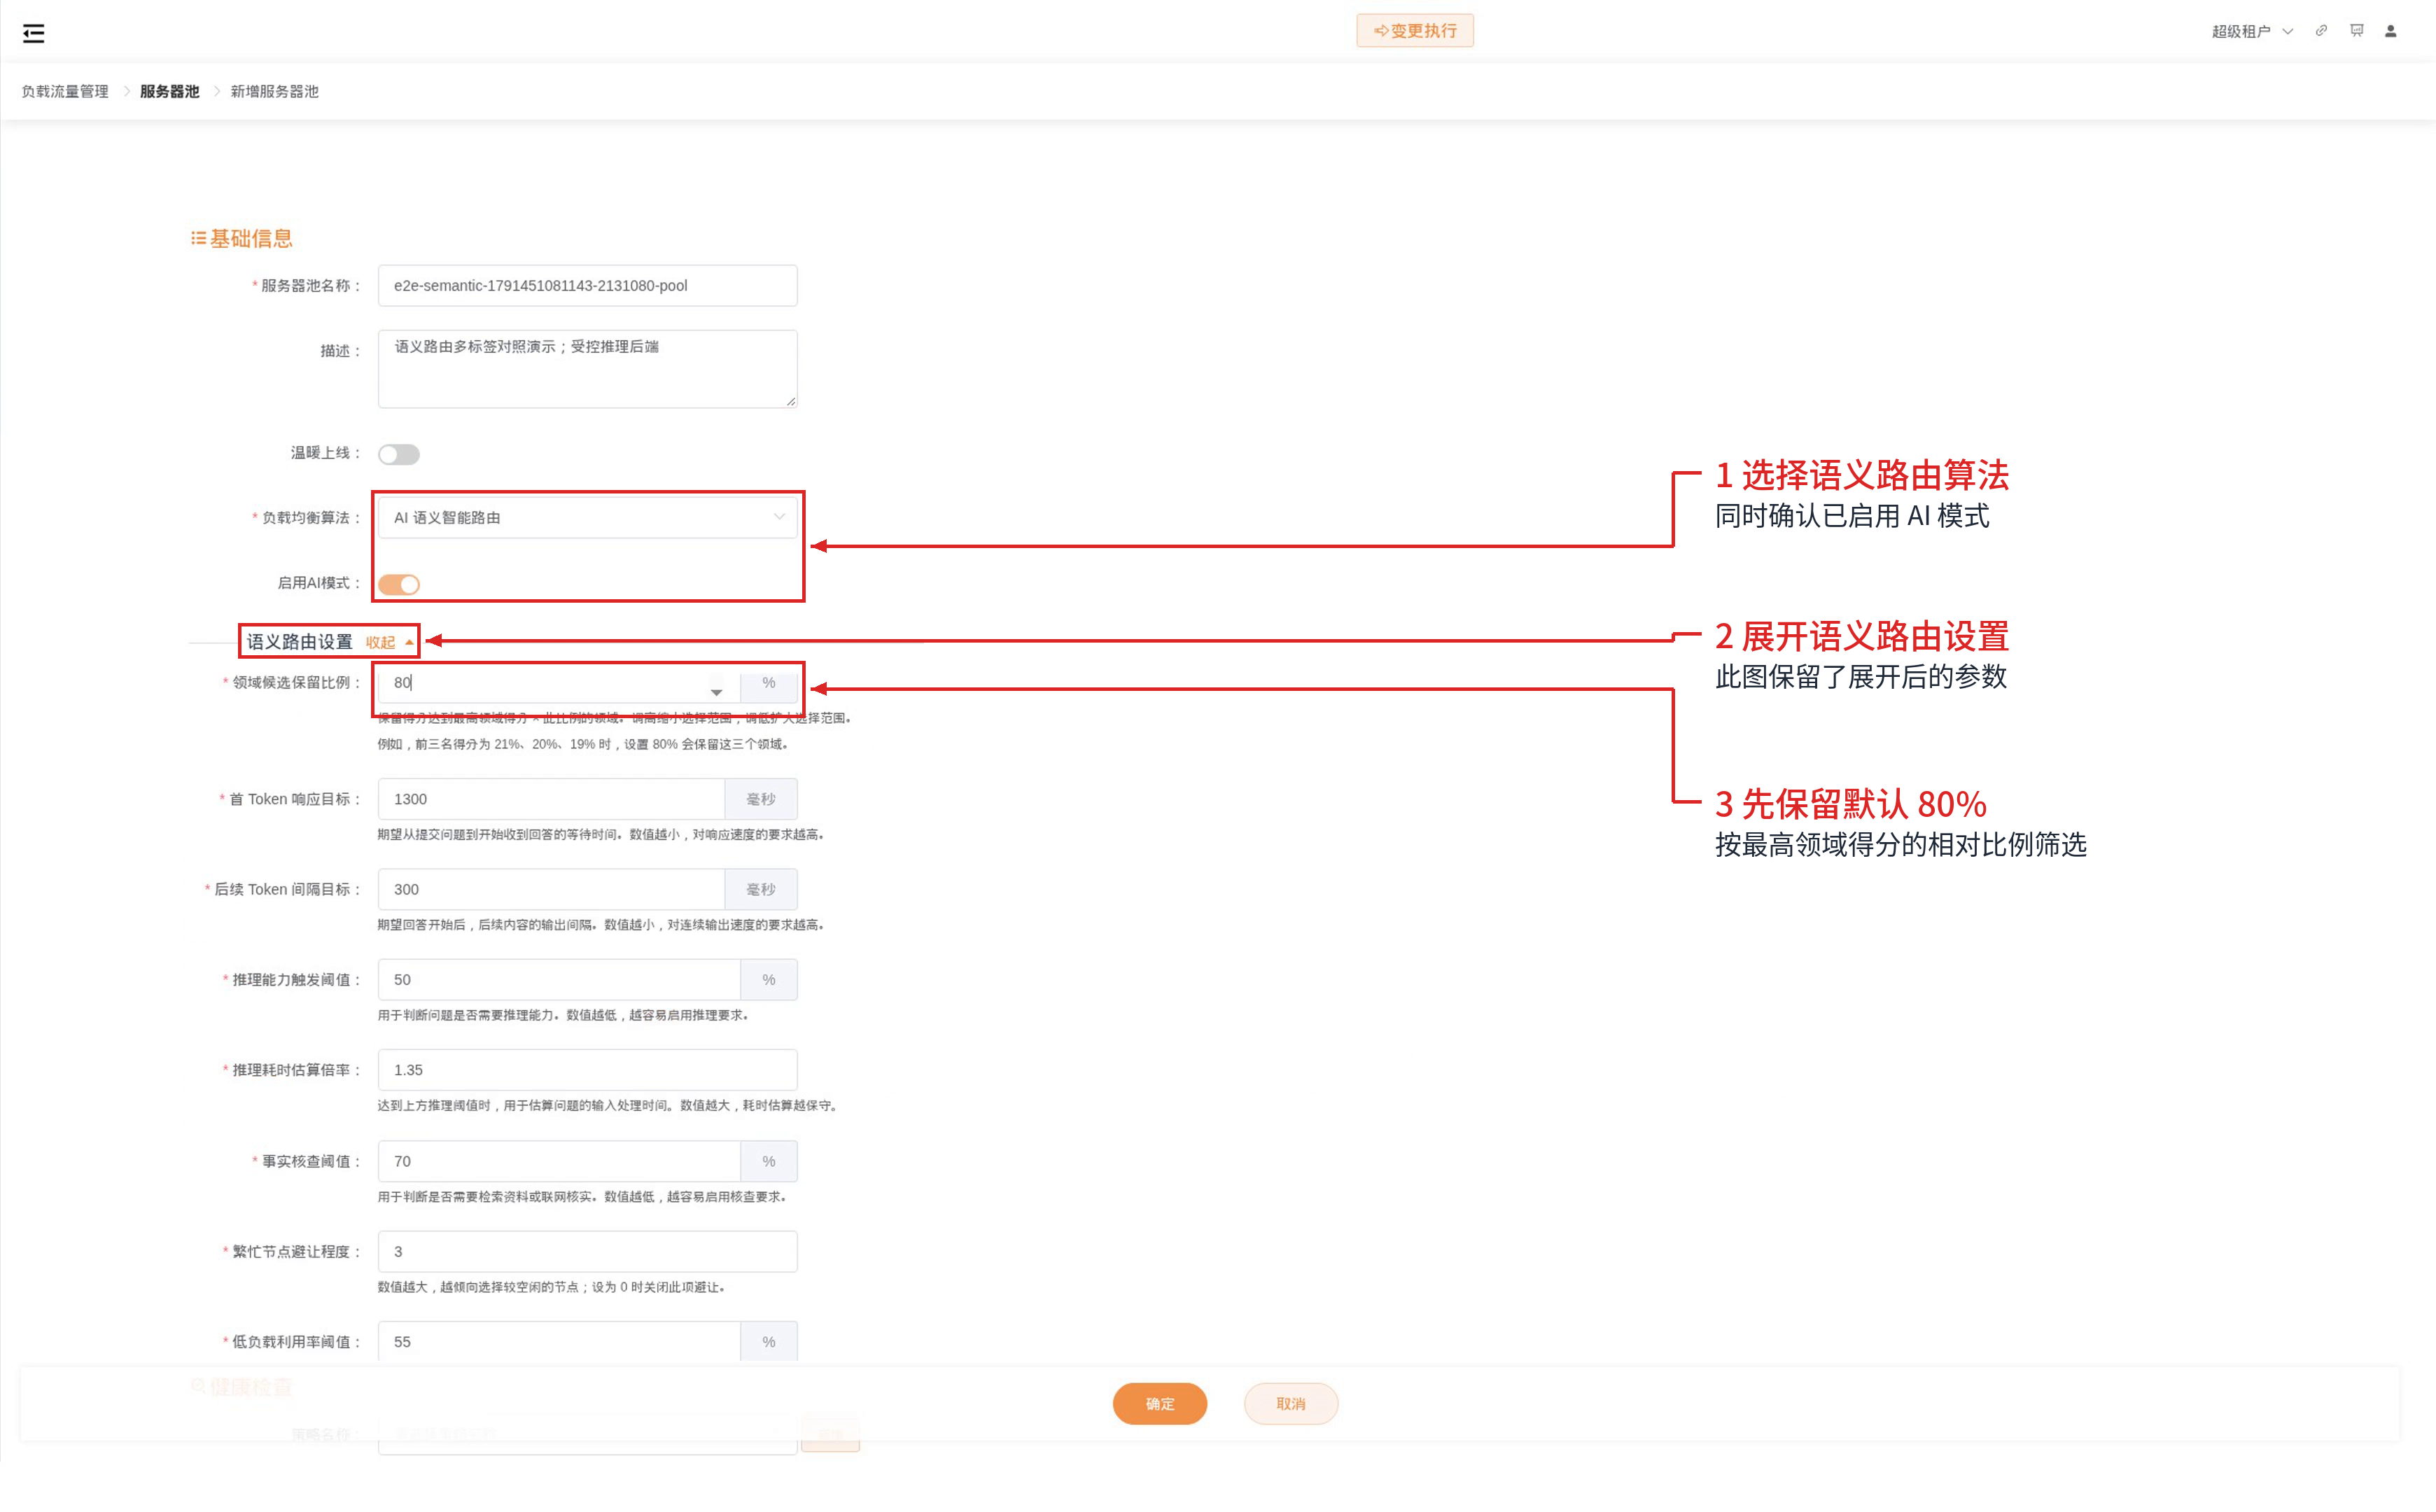
80%表示:保留得分不低于“最高领域得分 × 80%”的请求领域,不是识别准确率必须达到80%。例如最高得分为45%,边界就是36%;另一个领域得分43%时也会保留。某个推理组的能力标签与保留领域有交集,就获得领域匹配。
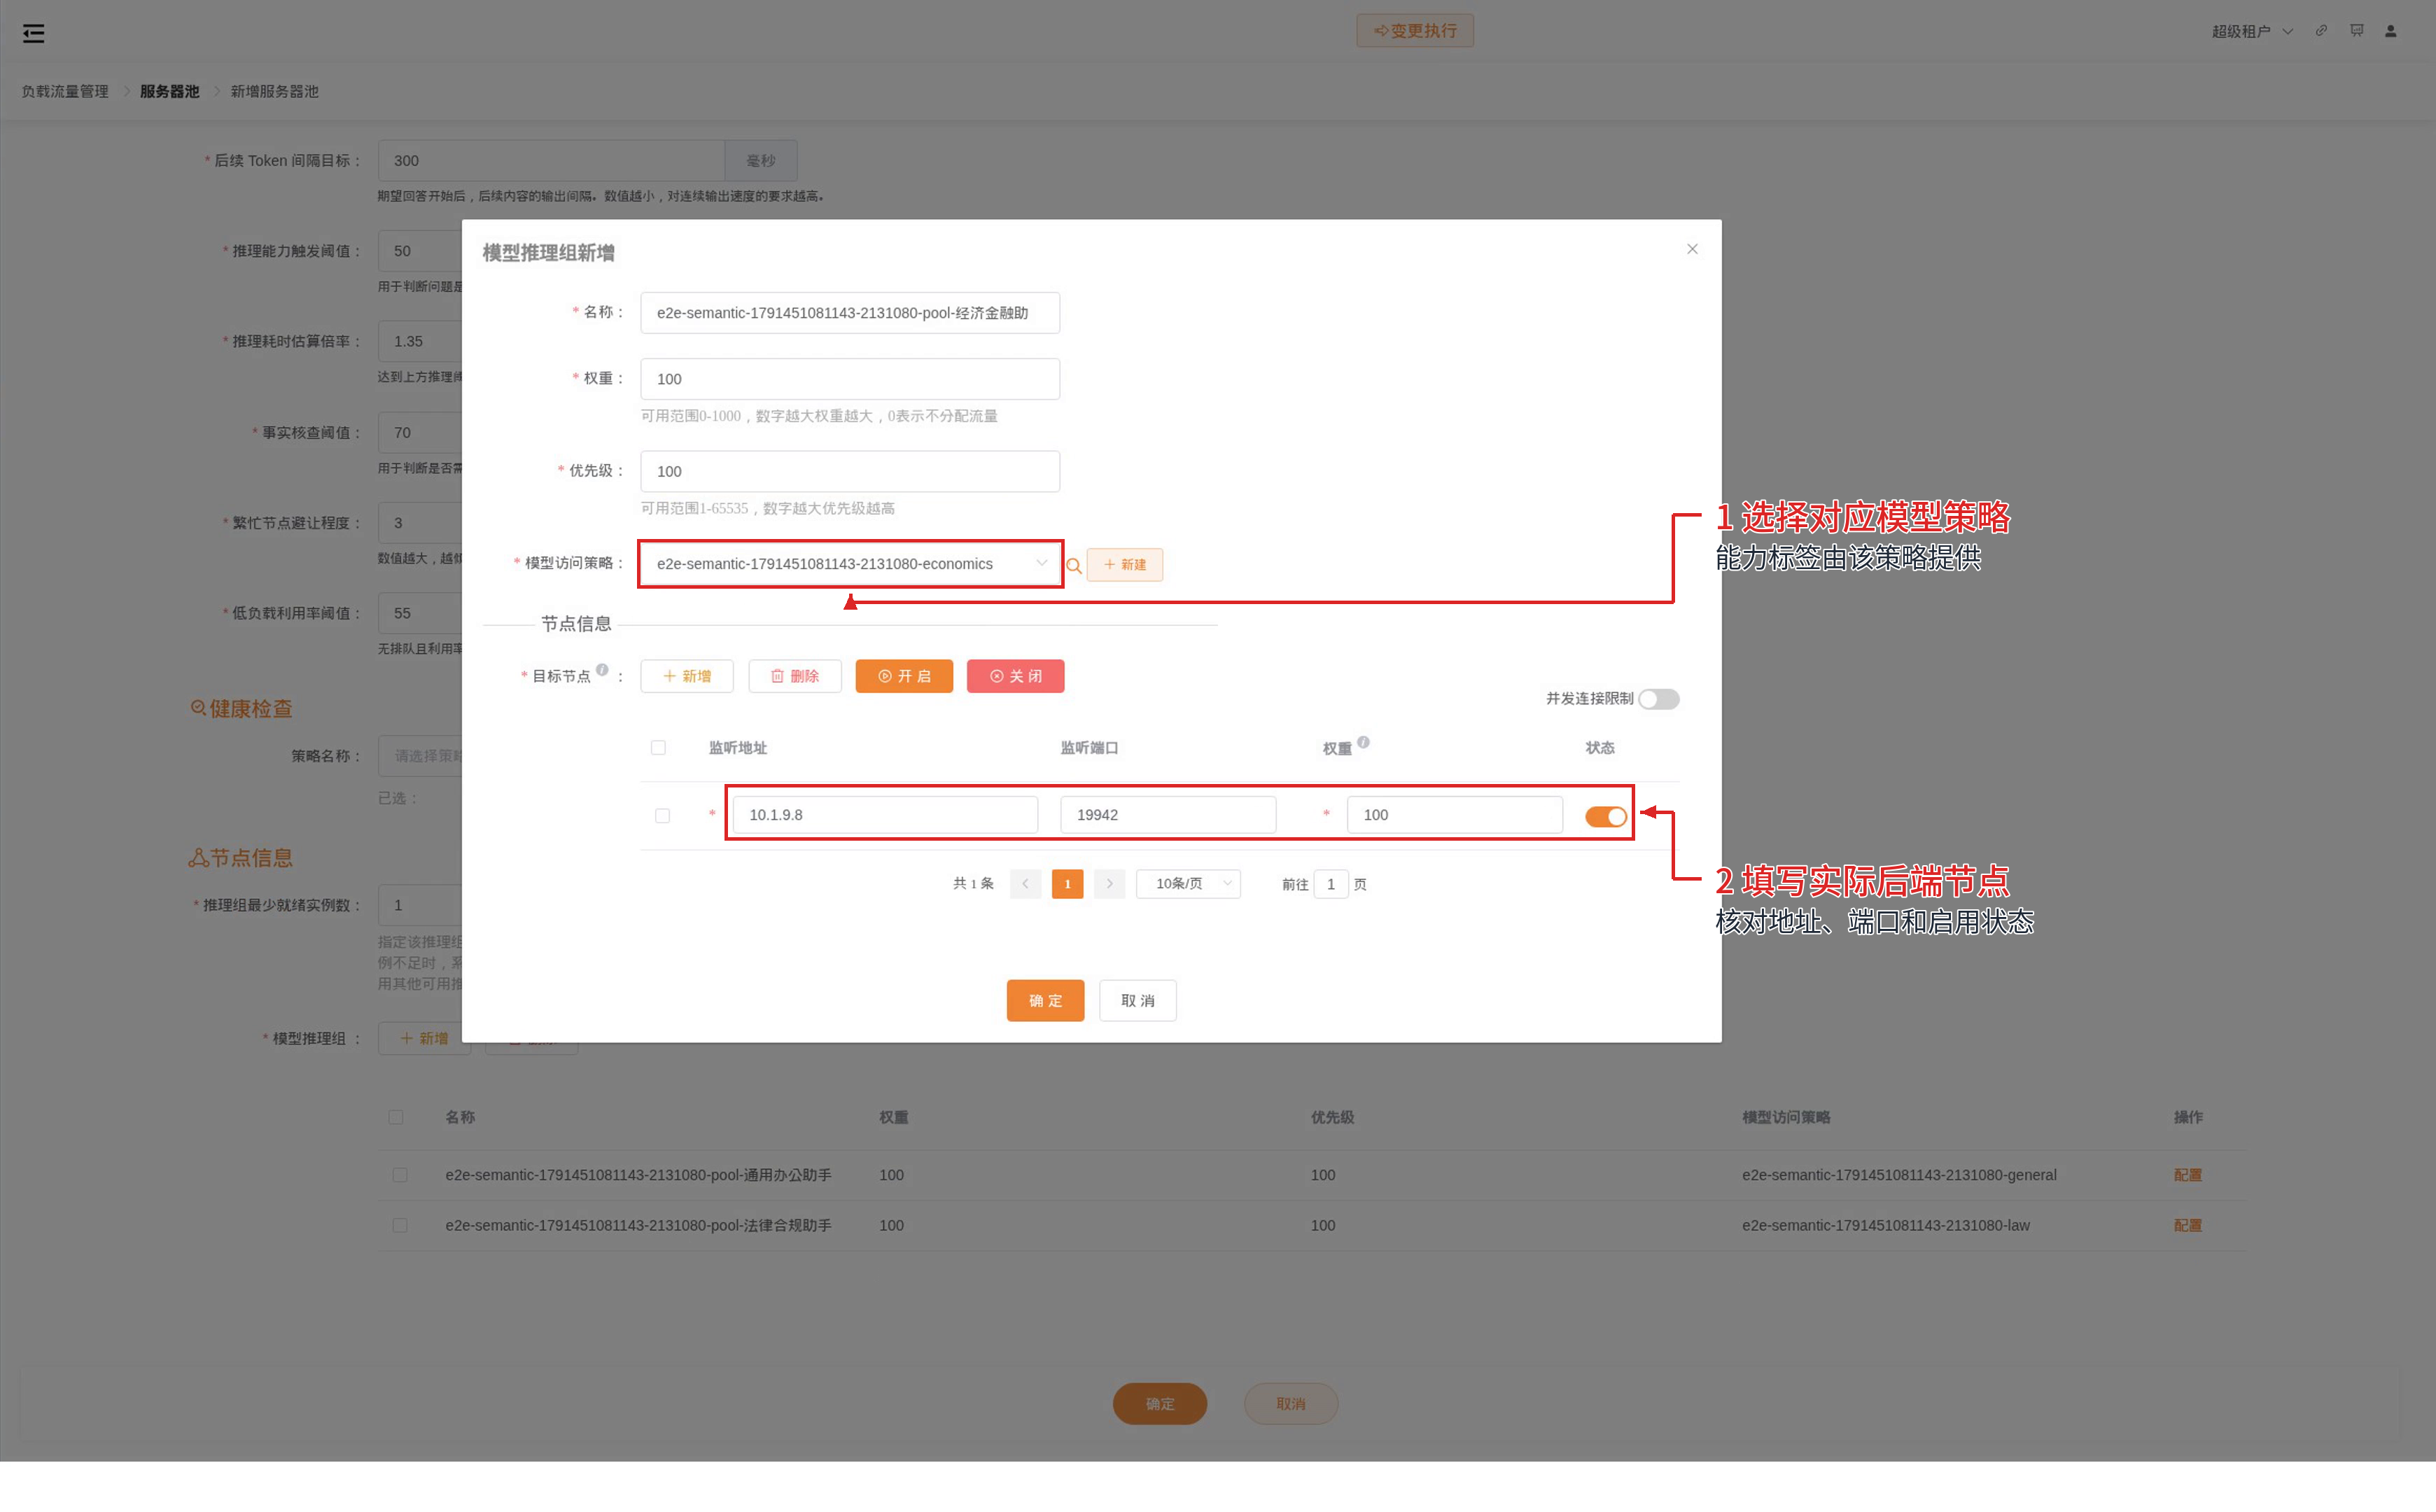
在“模型推理组”区域逐个新增通用办公助手、法律合规助手、经济金融助手。每组选择第二步的对应模型访问策略,并填写实际节点地址、端口及权重。组名便于识别,真正参与比较的领域标签来自绑定的策略;把组命名为“法律合规助手”不会自动赋予它法律能力。
先确认模型推理组选择的是本组策略,再填写实际后端节点地址、端口和启用状态。
完成各组配置后保存服务器池。普通 AI Fallback 的“先按优先级等级,再按权重分流”不能直接作为语义算法的选组规则。语义算法还会比较请求需求、模型能力及可用的运行数据,详见语义路由设置。
四、配置虚拟服务并发布
新增或修改虚拟服务,依次完成:
- 选择提供业务入口的转发引擎或流量组,配置可用的监听地址和端口。
- 开启“启用AI模式”,AI交互协议选择 OpenAI-API-Compatible。
- 开启“启用语义分析”。首次验证可选“手动选择”,明确选择第一步确认健康的语义引擎。
- 处理方式选择 HTTP代理或HTTPS代理,关联第三步的语义服务器池和适用的 HTTP策略;检查后端连接及回程配置。
- 按业务要求配置调用方访问授权。保存后点击页面顶部“变更执行”,等待完成,再开始聊天验证。
虚拟服务绑定语义引擎属于客户端入口的设置;只在服务器池选择语义算法,或只开启AI模式,都还没有完成这项关联。
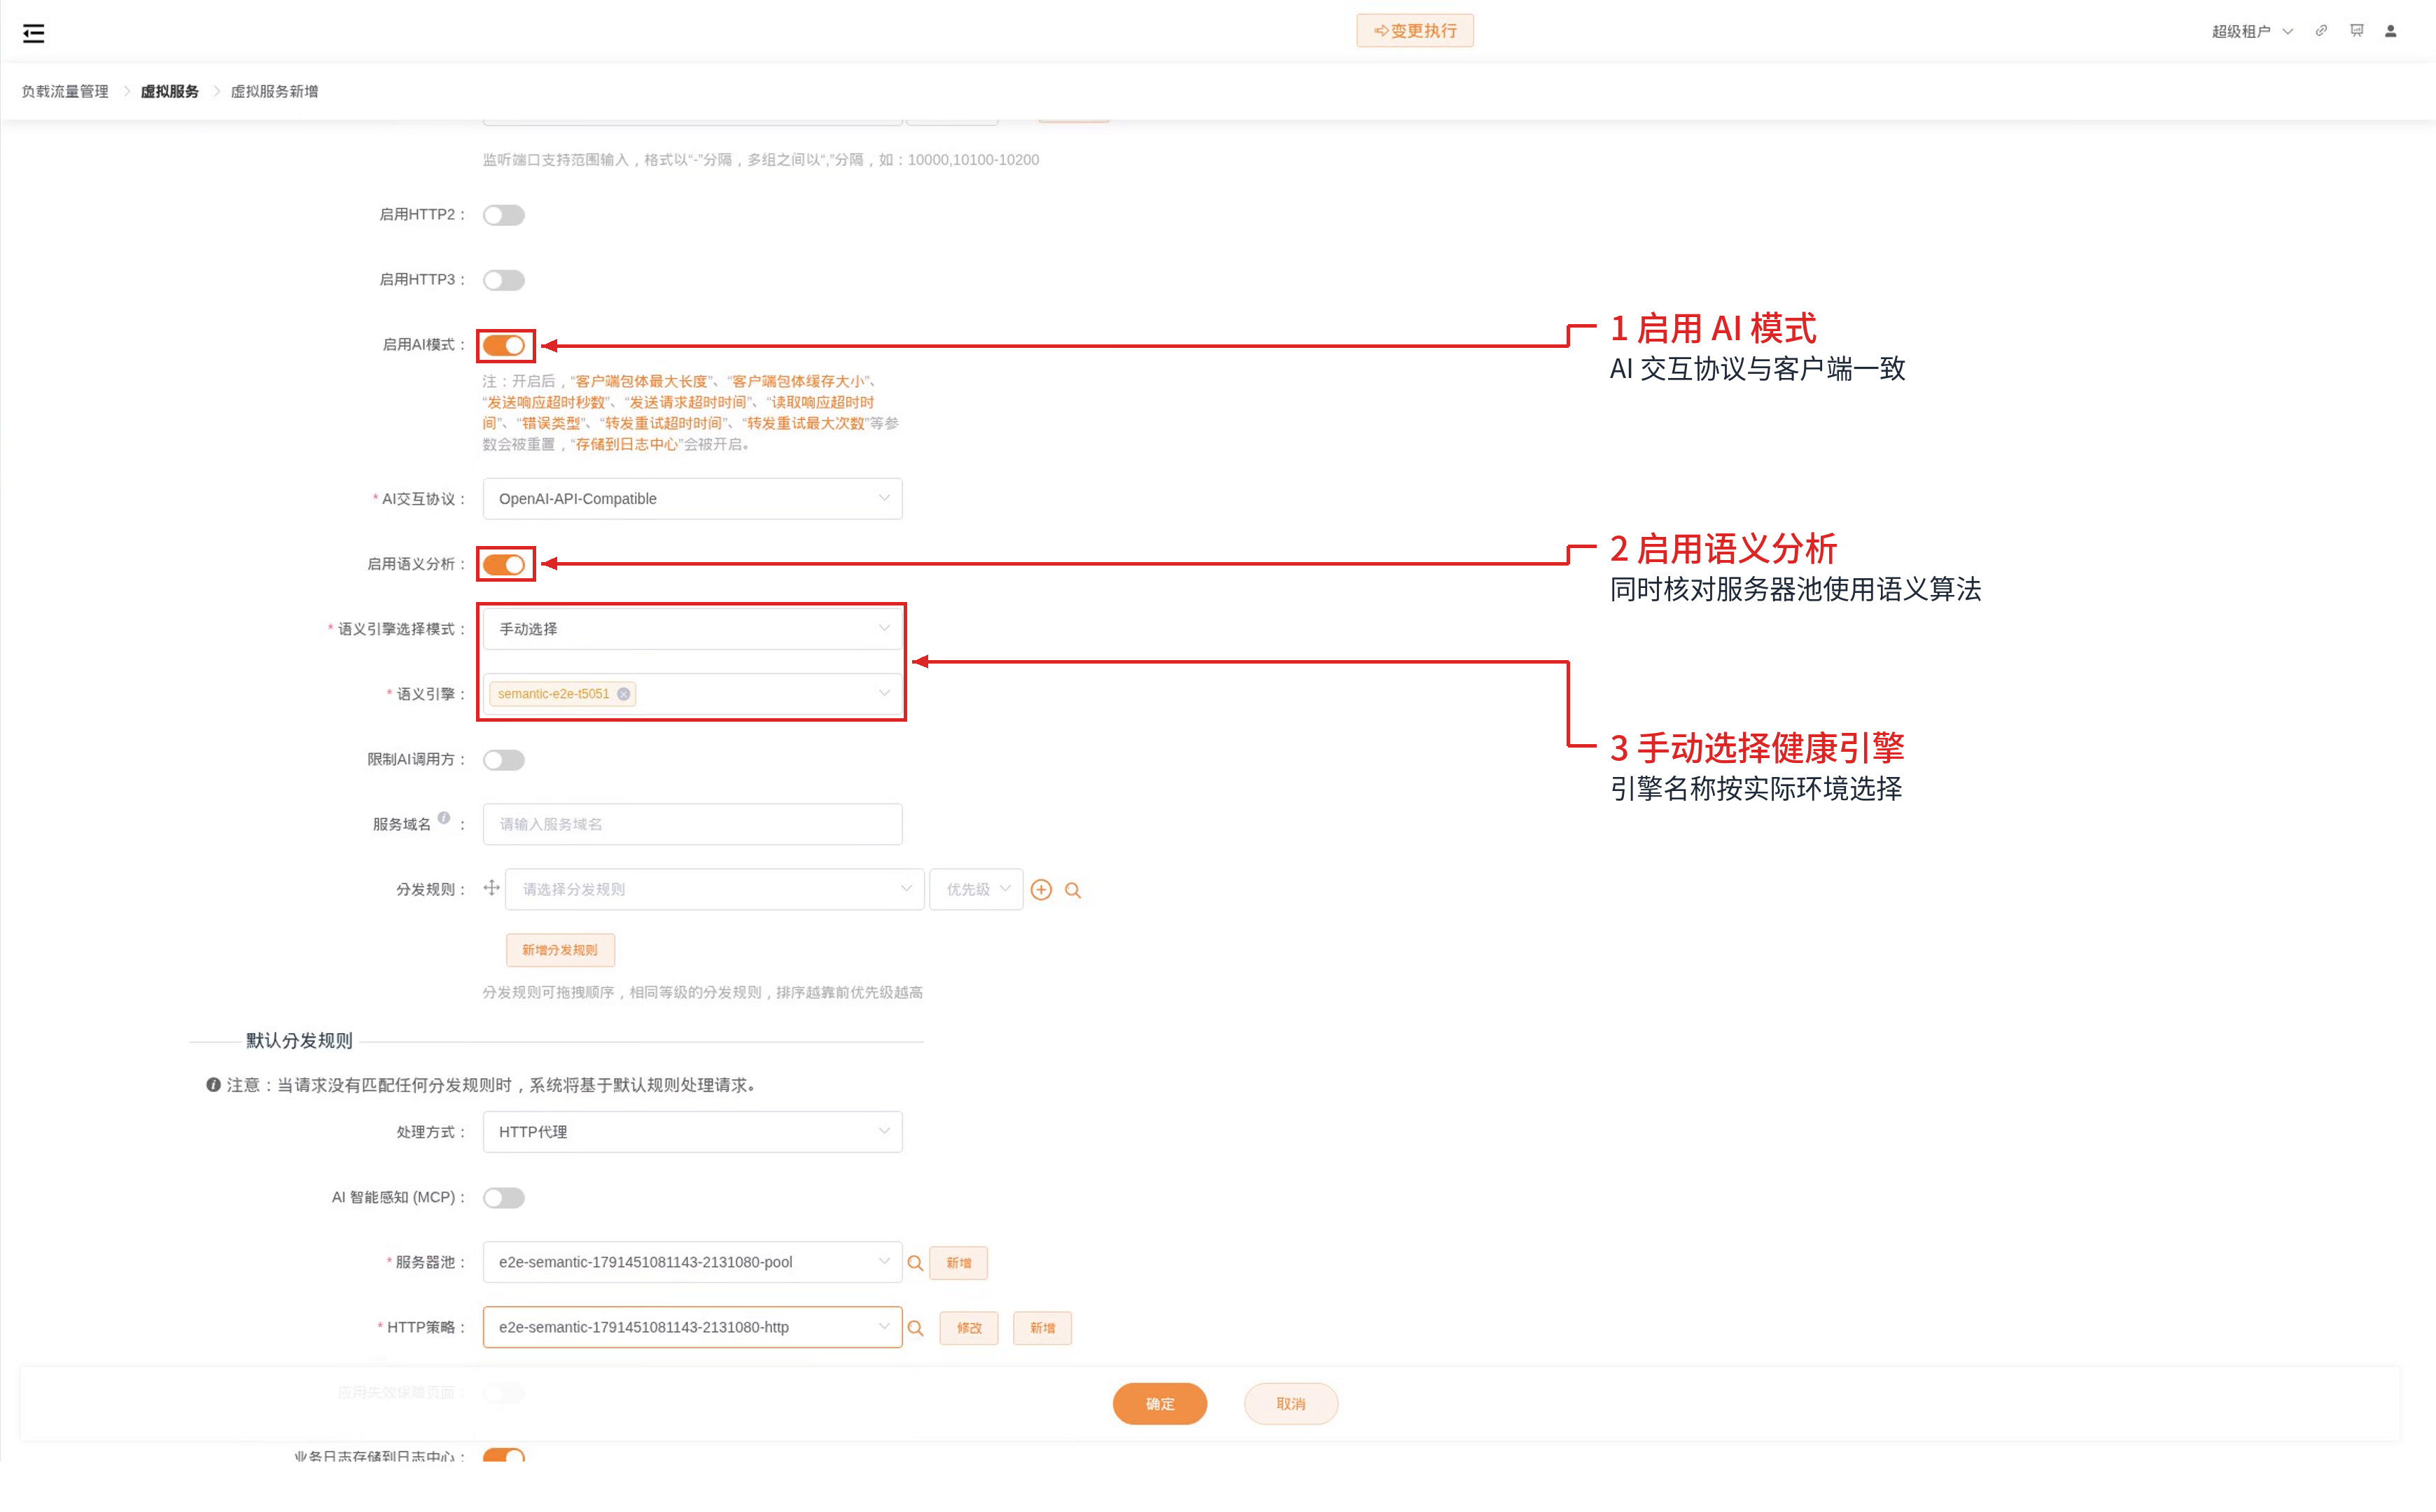
语义引擎绑定在虚拟服务上。模型转发策略用于提示词检查、附加和模板处理,并不能代替这项绑定。
客户端访问网关的凭证与网关访问模型的后端 API-Key 作用不同。开启“限制AI调用方”时,要选择允许的调用方,并让客户端使用其对应凭证;不要将后端供应商的 API-Key 直接当作网关调用方凭证。
五、用AIChat发送真实聊天请求
AIChat 服务应运行在能够访问虚拟服务的业务客户端上。浏览器用于输入问题和显示回答;模型请求由 AIChat 服务所在主机发出。不要把浏览器能打开管理页面,当成业务客户端到虚拟服务已经连通。
以下配置格式以 AIChat 0.30.0 为例。准备独立配置目录,在其中创建 config.yaml,替换入口地址和调用方凭证:
model: normae:auto
save: false
clients:
  - type: openai-compatible
    name: normae
    api_base: https://ai-gateway.example.com/v1
    api_key: YOUR_GATEWAY_CALLER_KEY
    models:
      - name: auto
max_input_tokens: 32768api_base填写虚拟服务业务入口,不是管理页面、语义引擎地址或模型节点地址。HTTPS证书需要被业务客户端信任。未启用调用方限制的受控验证环境可省略 api_key 项;实际业务按所配置的访问授权填写。max_input_tokens是客户端的输入限制,不是服务器池节点容量。
在业务客户端启动服务:
AICHAT_CONFIG_DIR=/path/to/aichat-demo aichat --serve 127.0.0.1:8000浏览器也在该机器时,打开 http://127.0.0.1:8000/playground。浏览器在另一台机器时,可在浏览器所在机器建立隧道,再打开 http://127.0.0.1:18091/playground:
ssh -N -L 18091:127.0.0.1:8000 user@BUSINESS_CLIENT_IP选择 normae:auto,点击“New Chat”(新聊天)后输入问题。连接名称前缀由客户端使用,发给网关的模型字段应为 model: "auto"。如果明确选择了具体模型,就是另一种模型选择方式,不能用其结果判断本例的自动语义选路。
展开本例使用的两条完整提问
法律问题:
在采购合同的法律审查中,违约责任、不可抗力和合同解除条款之间有什么关系?假设供货方迟延交付,随后主张不可抗力,采购方要求解除合同并赔偿损失。请从合同法的基本原理出发,逐步分析违约责任成立的条件、不可抗力与迟延履行之间的因果关系,以及解除合同与损害赔偿能否同时主张。这里只讨论法律分析方法,不查询现行法规或提供个案结论。
经济金融问题:
在宏观经济学中,利率变化如何通过货币政策传导机制影响企业融资成本和投资决策?假设政策利率下降,但商业银行风险溢价上升,请逐步解释政策利率、贷款利率、企业现金流和投资需求之间的关系,并分析为什么降息不一定带来所有企业融资成本同步下降。这里只讨论经济学原理,不查询实时市场数据或提供投资建议。
在上述多标签配置下,经济金融问题被送到同时配置了法律、经济学标签的法律合规助手。这里特意保留原组名,说明能力由标签配置决定。客户端选择的是 auto,不意味着后端也收到 auto。
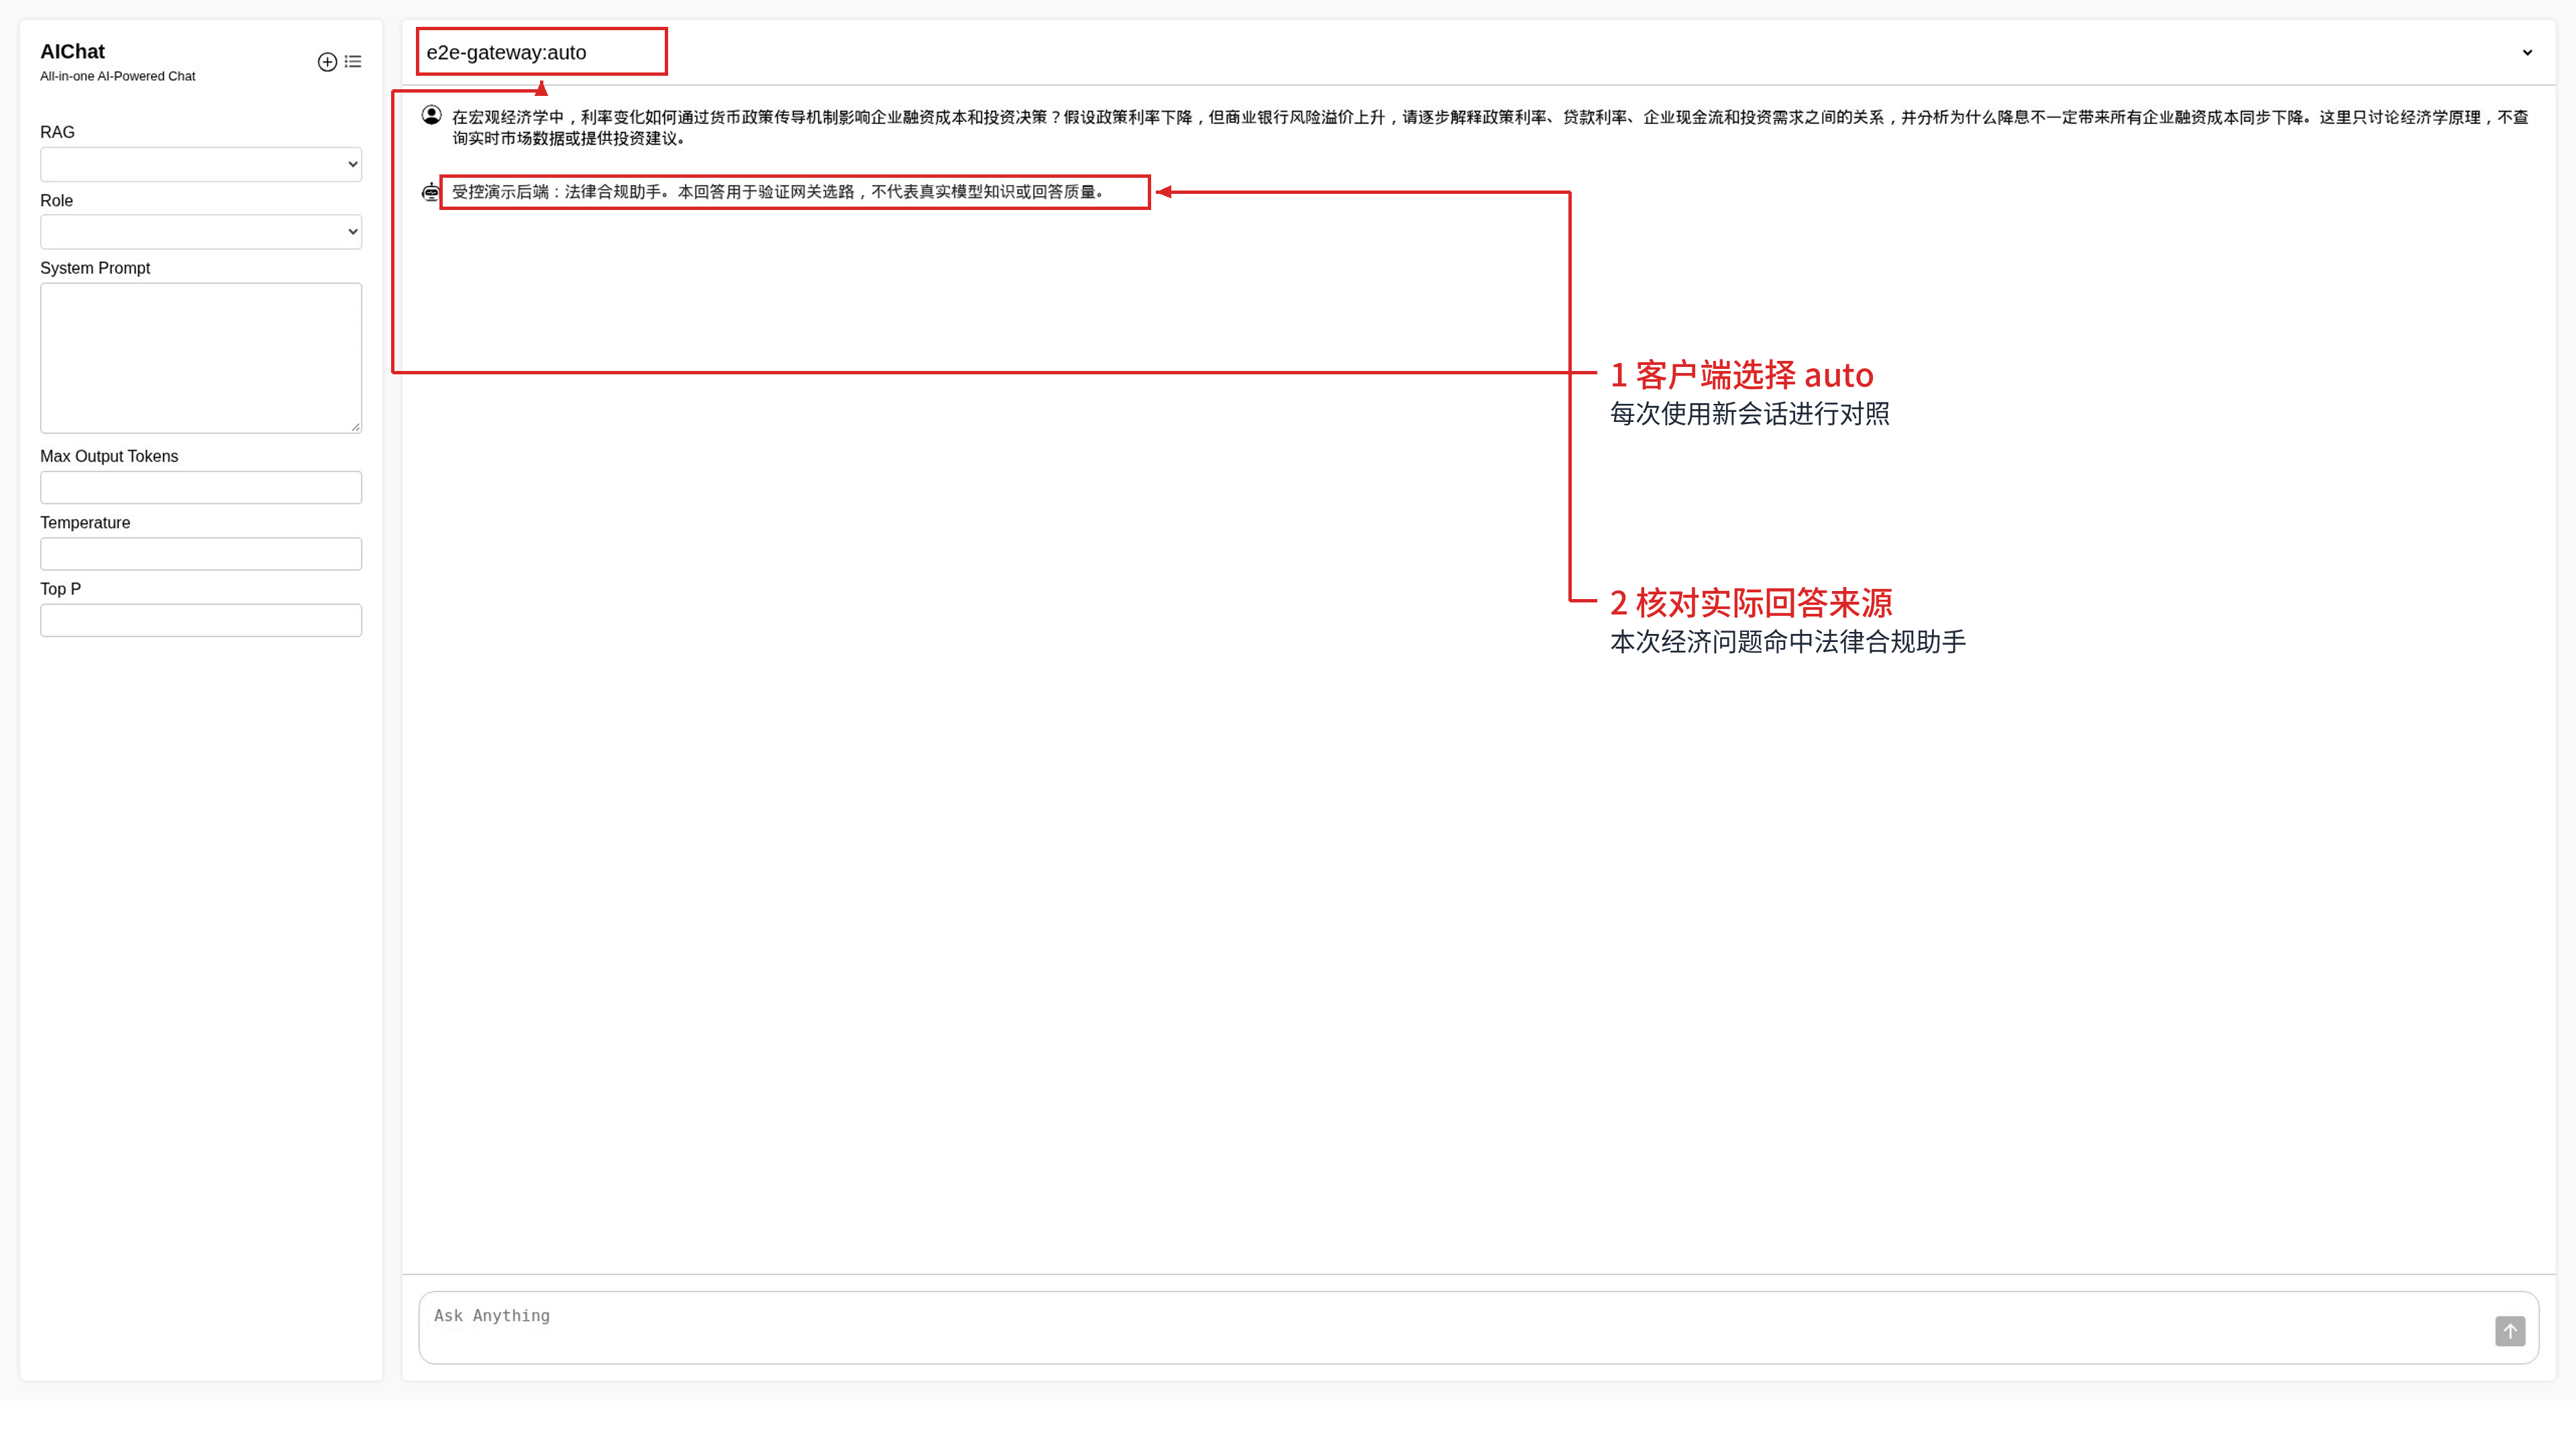
本例后端返回“受控演示后端”以便观察选组,回答不代表真实模型知识或回答质量。实际业务不要只凭回答文字判断后端身份,应同时查看虚拟服务日志中的命中推理组及模型信息,并与后端请求记录对应。
六、理解多标签与部分命中的对照
每次修改后先保存并执行配置变更,再用同一条问题新建聊天。对照时只修改表中指定的一组条件,其余保持不变;不要同时更换模型、权重和提问,否则难以判断是哪项配置影响了结果。
| 对照 | 本例改变的配置 | 本例观察到的结果 | 配置含义 |
|---|---|---|---|
| 部分能力命中 | 使用起始配置,模型推理方式为“通用” | 法律、经济金融问题分别进入对应助手 | 缺少深度推理偏好不等于所有已匹配能力失效 |
| 一个组有两个领域标签 | 法律合规助手增加经济学;经济金融助手临时改为计算机科学领域 | 两类问题都进入法律合规助手 | 任一领域命中即可,不要求同时命中全部标签 |
| 恢复领域标签 | 恢复起始领域配置 | 经济金融问题重新进入经济金融助手 | 对照的是同一问题在配置前后的选择 |
| 领域与意图竞争 | 保持起始领域;经济金融与通用办公助手的支持意图临时改为翻译,法律合规助手仍为通用问答 | 经济金融问题进入法律合规助手;恢复通用问答后重新进入经济金融助手 | 领域不是唯一比较维度,不能固定理解为领域永远优先 |
| 调整领域候选比例 | 从80%改为95%,再恢复80% | 这条问题两次均只保留经济学领域,并选中经济金融助手 | 比例改变只有跨过实际得分边界时才改变候选集合 |
| 节点关闭与恢复 | 经济金融节点关闭;法律合规助手临时只支持翻译,通用办公助手保持通用问答 | 经济金融问题进入通用办公助手;恢复节点及起始标签后进入经济金融助手 | 不可用节点不能因为领域匹配而继续接收新请求 |
本例为观察标签关系,使用独立演示池隔离前一阶段的运行历史。实际模型已有性能记录、质量或成本配置、负载变化时,综合比较可能得到不同结果。不能把上表写成固定的维度优先级,也不能据此承诺响应速度或最低成本。
七、什么时候需要外部知识能力
“外部”指模型自身知识之外的资料,不等于互联网。政府与金融机构的内部制度、办事指南、业务规程也属于外部知识来源。
| 后端实际能力 | 页面选择 | 适用任务示例 |
|---|---|---|
| 未接入知识库或联网工具 | 无 | 解释一般概念,或者分析用户在问题中提供的完整材料 |
| 已接入指定知识库并能检索 | 检索增强 | 根据本单位采购管理制度说明审批流程,查询内部业务规程 |
| 已具备公开资料检索能力 | 联网 | 核对公开发布的政策及其来源、发布日期 |
这些任务是后续接入建议,不是本例已验证的检索结果。本例三个后端的外部知识能力均为“无”,演示标记只能证明选路。
能力标签是对后端现有能力的声明:选择“检索增强”不会自动导入文件或建立知识库,选择“联网”也不会自动配置搜索工具。资料范围、更新机制、用户权限及引用来源需要由实际后端服务配置和验证。
当前选路在识别出核查需求后,将“检索增强”和“联网”都视为这一维度的能力匹配;仅靠此标签,不能保证某条问题一定查询内部库而不查询互联网。若某入口只允许使用内部资料,应仅关联获准的后端,并配置相应访问和网络控制,不能把标签当作权限隔离。
后续验证真实检索时,除核对命中推理组,还应检查检索来源、资料版本和回答引用是否一致。字段说明见外部知识能力。
八、配置不符合预期时先查哪里
| 现象 | 优先核对 |
|---|---|
| AI模式已开启,却没有按领域选组 | 池算法是否为AI语义智能路由;虚拟服务是否启用语义分析并关联可用引擎 |
| 标签修改后结果没变 | 是否改到该组实际引用的策略;是否完成变更执行;同一策略是否被其他组共用 |
| 增加标签后没有优先选择该组 | 标签是否与本次请求候选领域相交;其他任务能力和节点状态如何;不要按标签数量比较 |
| AIChat始终请求同一个模型 | 客户端是否选择自动模型;是否误把具体后端模型名固定在请求里 |
| 返回401或403 | 核对调用方限制、客户端凭证及模型访问权限,再排查模型后端自身的鉴权;不要混用两类API-Key |
| 引擎健康,聊天仍失败 | 还要核对虚拟服务监听、业务客户端连通性、池关联、节点可用性及后端协议与模型名称 |
| 已关闭节点仍看到旧聊天输出 | 区分关闭前已建立的请求与配置发布后的新请求;使用新会话重新核对 |
| 修改候选比例后选组没变 | 得分集合可能未跨过新边界;相同比例对不同问题的候选范围也可能不同 |